[CS 기초] 자료구조 9가지 상세 정리 — 배열부터 트라이까지, 복잡도와 실제 쓰임
자료구조는 데이터를 메모리에 어떻게 배치하고 연결하느냐에 대한 선택이다. 같은 데이터라도 배치 방법에 따라 “500번째 항목 찾기”, “중간에 끼워 넣기”, “가장 작은 값 꺼내기” 같은 연산의 비용이 수천 배 차이 난다. 이 글은 자주 쓰이는 9가지 자료구조를 각각 다음 순서로 정리했다.
- 어떤 문제를 해결하는가
- 내부 구조와 동작
- 연산별 시간 복잡도
- Python 예시 (모두 Python 3.13에서 실행해 출력 확인)
- 실제 사용처
- 흔한 설명에서 빠지거나 부정확한 부분
마지막 장에는 이 자료구조들이 Active Directory와 인프라 운영에서 실제로 어디에 나타나는지 확인한 내용을 붙였다. 다이어그램은 직접 작성했다.
0. 시간 복잡도 표기 (Big-O)
데이터가 n개일 때 연산 비용이 n에 따라 어떻게 늘어나는지를 나타낸다. 정확한 시간이 아니라 증가 추세다.
| 표기 | 이름 | n = 1,000일 때 대략 | 예 |
|---|---|---|---|
| O(1) | 상수 | 1 | 배열 인덱스 접근, 해시 테이블 조회(평균) |
| O(log n) | 로그 | 10 | 균형 이진 탐색 트리 검색, 힙 삽입 |
| O(n) | 선형 | 1,000 | 연결 리스트 탐색, 배열 중간 삽입 |
| O(n log n) | 선형 로그 | 10,000 | 병합 정렬, 힙 정렬 |
| O(n²) | 이차 | 1,000,000 | 이중 반복문 비교 |
두 가지를 구분해 둔다.
- 평균과 최악: 해시 테이블 조회는 평균 O(1)이지만 최악 O(n)이다. 어떤 경우를 말하는지 함께 봐야 한다.
- 분할 상환(amortized): 대부분은 O(1)이고 가끔 O(n)이 걸리지만, 긴 연산 순서 전체로 나누면 한 번당 O(1)인 경우다. 동적 배열의 끝 추가가 대표적이다.
1. 배열 (Array)
구조
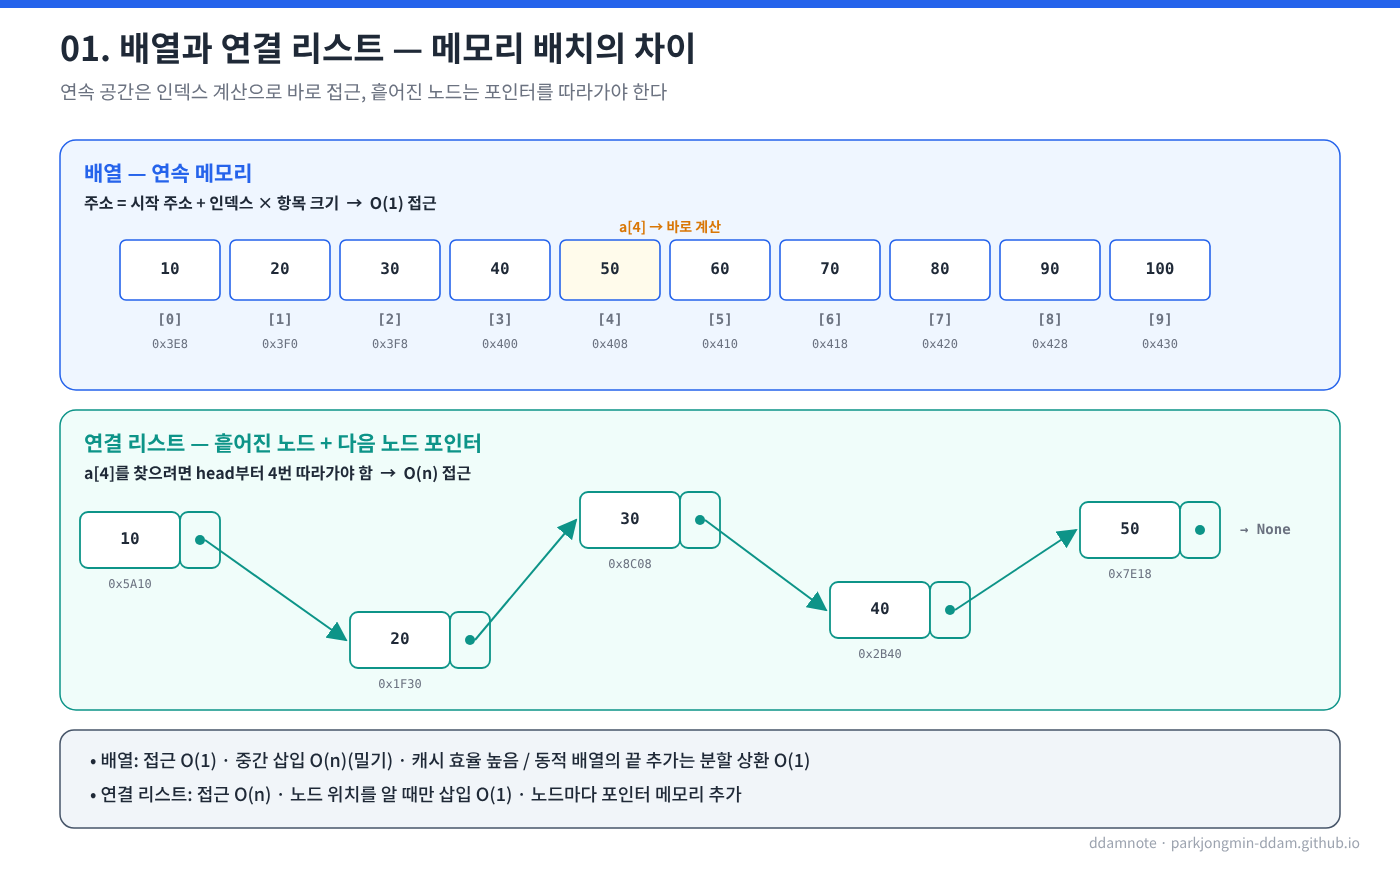
같은 크기의 항목을 메모리의 연속된 공간에 순서대로 저장한다. 각 항목은 0부터 시작하는 인덱스를 가진다. 시작 주소와 항목 크기를 알면 시작 주소 + 인덱스 × 항목 크기로 어떤 항목의 위치든 바로 계산할 수 있다. 500번째 항목을 찾기 위해 앞의 499개를 볼 필요가 없다.
복잡도
| 연산 | 정적 배열 | 동적 배열 (Python list) |
|---|---|---|
| 인덱스 접근 | O(1) | O(1) |
| 끝에 추가 | 불가 (크기 고정) | 분할 상환 O(1) |
| 중간 삽입·삭제 | O(n) | O(n) |
| 값으로 검색 | O(n) | O(n) |
| 정렬된 배열에서 이진 탐색 | O(log n) | O(log n) |
정적 배열과 동적 배열
“배열은 크기가 고정이라 늘리려면 새 배열을 만들어 복사해야 한다”는 설명은 정적 배열(C의 int a[10])에 해당한다. 실무에서 주로 쓰는 것은 동적 배열이다. Python의 list, Java의 ArrayList, C++의 vector가 여기에 해당한다.
동적 배열은 실제 필요한 것보다 큰 공간을 미리 잡아 두고, 다 차면 더 큰 공간(보통 1.x~2배)을 새로 잡아 전체를 복사한다. 복사는 O(n)이지만 드물게 일어나므로, 끝에 추가하는 연산은 분할 상환 O(1)이다.
import sys

a = []
prev = sys.getsizeof(a)
for i in range(20):
    a.append(i)
    size = sys.getsizeof(a)
    if size != prev:
        print(f"len={len(a):2d}  bytes={size}")
        prev = size
len= 1  bytes=88
len= 5  bytes=120
len= 9  bytes=184
len=17  bytes=248
20개를 넣는 동안 메모리 재할당은 4번만 일어났다. 정확한 크기와 증가 비율은 Python 버전과 플랫폼에 따라 다르다.
중간 삽입이 느린 이유
연속 공간을 유지해야 하므로, 중간에 하나를 넣으면 그 뒤의 항목을 모두 한 칸씩 밀어야 한다. list.insert(0, x)와 list.pop(0)은 O(n)이다. 앞쪽 삽입·삭제가 잦으면 4장의 deque를 쓴다.
실제 사용처
- 이미지의 픽셀 행, 문자열의 문자, 행렬, 정렬 알고리즘의 입력
- 다른 자료구조의 기반: 힙(7장), 해시 테이블의 버킷 배열(5장), 스택(3장)
보강: 캐시 지역성
연속 메모리는 CPU 캐시와 잘 맞는다. 하나를 읽을 때 근처 데이터가 캐시에 함께 올라오므로 순차 접근이 매우 빠르다. 이론상 같은 O(n) 순회라도 배열이 연결 리스트보다 실제로 몇 배 빠른 이유다.
2. 연결 리스트 (Linked List)
구조
항목을 메모리 여기저기에 흩어 저장하고, 각 항목(노드)이 다음 노드의 위치(포인터)를 가진다. 보물찾기처럼 각 쪽지는 다음 쪽지의 위치만 안다.
| 종류 | 구조 |
|---|---|
| 단일 연결 리스트 | 각 노드가 다음 노드만 가리킴 |
| 이중 연결 리스트 | 각 노드가 이전·다음 노드를 모두 가리킴. 역방향 순회와 O(1) 삭제 가능 |
| 원형 연결 리스트 | 마지막 노드가 첫 노드를 가리킴 |
복잡도
| 연산 | 복잡도 | 조건 |
|---|---|---|
| 인덱스 접근 | O(n) | 처음부터 따라가야 함 |
| 맨 앞 삽입·삭제 | O(1) | |
| 노드 위치를 이미 알 때 그 뒤에 삽입 | O(1) | 포인터 두 개만 수정 |
| 특정 값 위치에 삽입 | O(n) | 위치를 찾는 데 O(n) |
| 검색 | O(n) |
보강: “중간 삽입이 O(1)”의 조건
흔히 “중간 삽입은 포인터 두 개만 바꾸면 되니 O(1)”이라고 설명한다. 이는 삽입할 위치의 노드를 이미 손에 쥐고 있을 때만 맞다. “500번째 위치에 넣어라”라면 500번째 노드까지 따라가는 데 O(n)이 걸린다. 결국 “인덱스 기준 중간 삽입”은 배열과 연결 리스트 모두 O(n)이고, 차이는 배열은 밀기 비용, 연결 리스트는 찾기 비용이라는 점이다.
class Node:
    def __init__(self, value, next=None):
        self.value = value
        self.next = next

# 1 -> 2 -> 4
head = Node(1, Node(2, Node(4)))

# 노드 2를 이미 알고 있으면 그 뒤 삽입은 O(1)
node2 = head.next
node2.next = Node(3, node2.next)

cur, out = head, []
while cur:
    out.append(cur.value)
    cur = cur.next
print(out)
[1, 2, 3, 4]
실제 사용처
- LRU 캐시: 해시 테이블(키 → 노드) + 이중 연결 리스트(사용 순서). 조회와 “가장 오래된 항목 제거”를 모두 O(1)로 한다. Python의
collections.OrderedDict가 이 구조를 쓴다. - 운영체제 커널의 각종 목록, 메모리 할당기의 빈 블록 목록
- 다른 자료구조의 구현 수단: 해시 테이블 체이닝(5장), 큐(4장)
배열보다 캐시 효율이 낮고 노드마다 포인터 메모리가 추가로 든다. 애플리케이션 코드에서 연결 리스트를 직접 만들 일은 많지 않고, 대부분 위와 같이 다른 구조의 부품으로 쓰인다.
3. 스택 (Stack)
구조
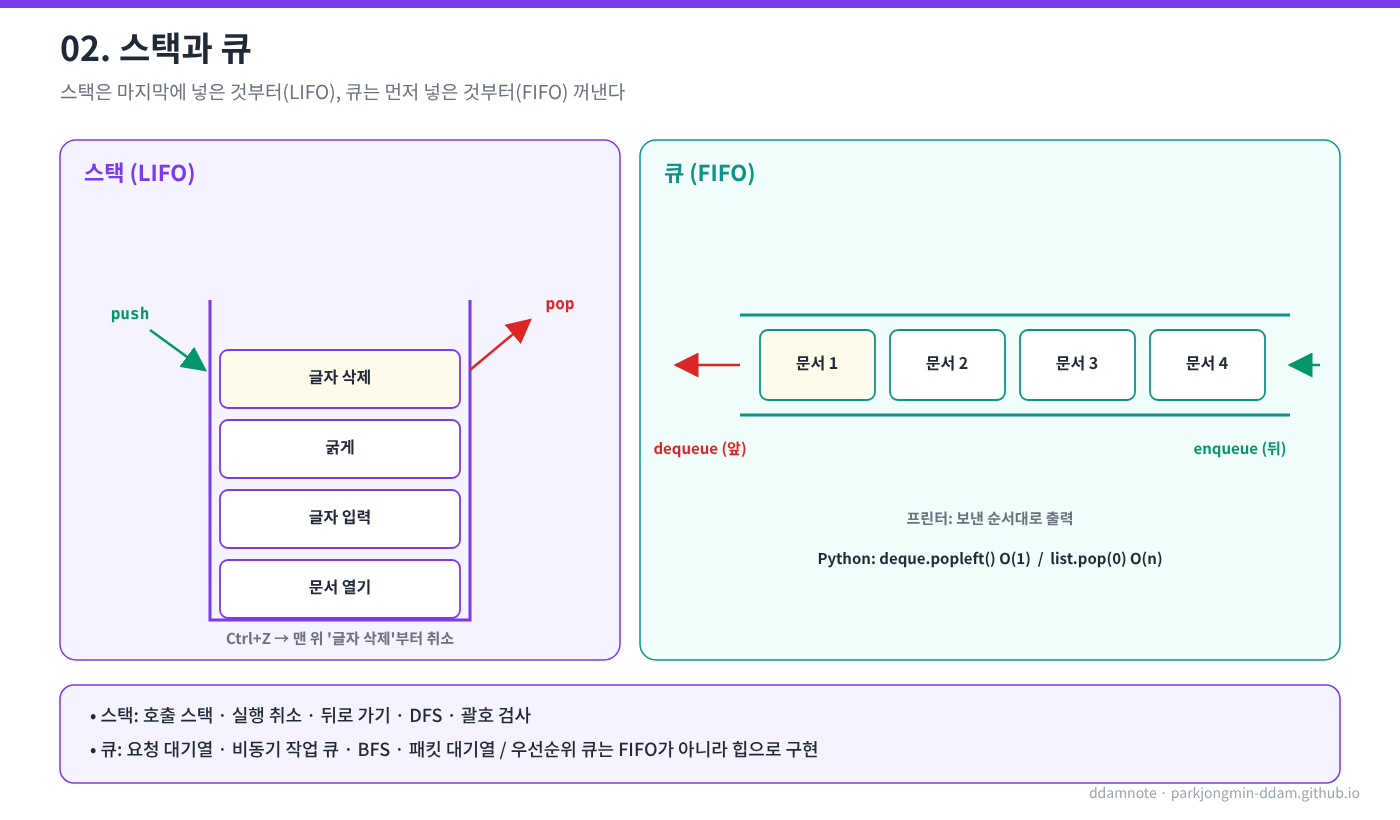
후입선출(LIFO, Last In First Out). 마지막에 넣은 것을 먼저 꺼낸다. 접시를 쌓을 때 위에 올리고 위에서 꺼내는 것과 같다. 연산은 위에 넣기(push), 위에서 꺼내기(pop), 위를 보기(peek)뿐이다.
복잡도
| 연산 | 복잡도 |
|---|---|
| push | O(1) (동적 배열 기반이면 분할 상환) |
| pop | O(1) |
| peek | O(1) |
Python에서는 list의 append와 pop()이 스택이다. 끝에서만 넣고 빼므로 밀기 비용이 없다.
예시: 괄호 짝 검사
def balanced(s: str) -> bool:
    pairs = {")": "(", "]": "[", "}": "{"}
    stack = []
    for ch in s:
        if ch in "([{":
            stack.append(ch)
        elif ch in pairs:
            if not stack or stack.pop() != pairs[ch]:
                return False
    return not stack

print(balanced("{[()()]}"), balanced("([)]"), balanced("(("))
True False False
실제 사용처
- 호출 스택: 함수가 다른 함수를 부르면 현재 위치를 스택에 넣고, 안쪽 함수가 끝나면 꺼내 돌아온다. 재귀가 너무 깊으면 이 스택이 넘친다(스택 오버플로, Python의
RecursionError). - 실행 취소(Ctrl+Z): 작업을 스택에 쌓고, 취소할 때 맨 위를 꺼낸다. 다시 실행(Ctrl+Y)까지 하려면 취소한 작업을 담는 스택이 하나 더 필요하다.
- 브라우저 뒤로 가기·앞으로 가기: 역시 스택 두 개로 구현한다.
- 깊이 우선 탐색(DFS, 8장), 수식 계산과 파서
4. 큐 (Queue)
구조
선입선출(FIFO, First In First Out). 먼저 들어온 것을 먼저 꺼낸다. 매장 계산 줄과 같다. 뒤에 넣기(enqueue)와 앞에서 꺼내기(dequeue)가 기본 연산이다.
복잡도와 구현 주의
| 구현 | enqueue | dequeue |
|---|---|---|
list.append + list.pop(0) |
O(1) | O(n) — 앞을 꺼낼 때마다 전체를 당김 |
collections.deque |
O(1) | O(1) |
| 원형 버퍼 (고정 크기 배열 + 앞·뒤 인덱스) | O(1) | O(1) |
from collections import deque
import timeit

n = 50_000
t_list = timeit.timeit(lambda: [l.pop(0) for l in [list(range(n))] for _ in range(n)], number=1)
t_deque = timeit.timeit(lambda: [d.popleft() for d in [deque(range(n))] for _ in range(n)], number=1)
print(f"list.pop(0): {t_list:.3f}s, deque.popleft(): {t_deque:.4f}s")
list.pop(0): 0.215s, deque.popleft(): 0.0036s
5만 개 기준으로 수십 배 차이가 난다(측정값은 환경에 따라 다르다). Python에서 큐는 deque로 만든다.
변형
| 변형 | 동작 | 예 |
|---|---|---|
| 덱 (deque) | 양쪽 끝에서 넣고 뺄 수 있음 | 슬라이딩 윈도우, 작업 훔치기(work stealing) |
| 우선순위 큐 | 들어온 순서가 아니라 우선순위가 높은 것부터 | 응급실 환자 분류. 구현은 보통 힙(7장) |
| 원형 큐 | 고정 크기, 끝에 닿으면 앞으로 돌아감 | 오디오·네트워크 버퍼, 로그 링 버퍼 |
실제 사용처
- 프린터 대기열, 음악 재생 목록
- 웹 서버의 요청 대기열, 비동기 작업 큐(Celery, SQS, RabbitMQ). API 설계 패턴의 비동기 API가 이 구조다.
- 너비 우선 탐색(BFS, 8장)
- 네트워크 장비의 패킷 송신 대기열
5. 해시 테이블 (Hash Table)
구조
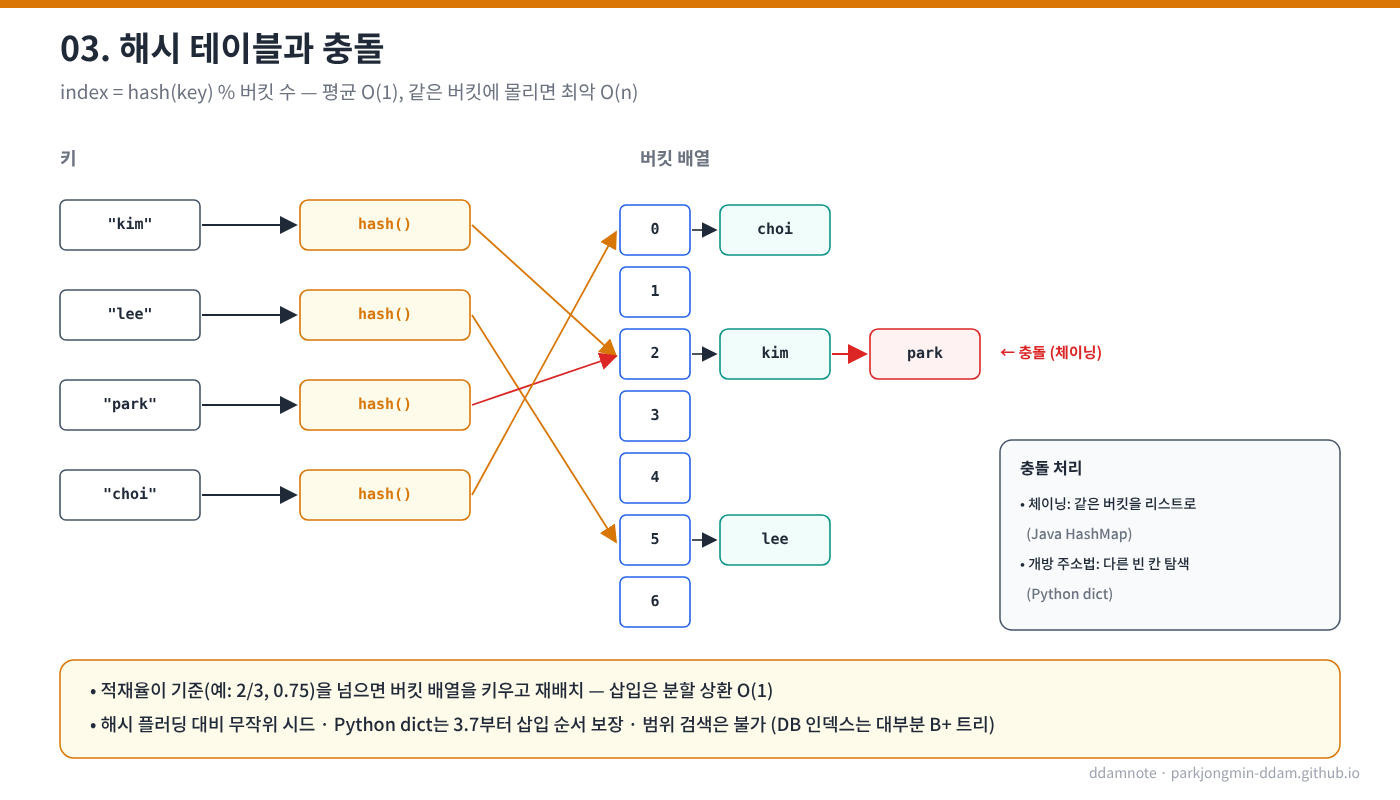
키를 해시 함수에 넣어 정수로 바꾸고, 그 정수를 버킷 배열의 인덱스로 써서 값을 저장한다. 조회할 때도 같은 함수로 같은 인덱스를 계산해 바로 찾아간다. 순회나 정렬 없이 키에서 위치로 바로 간다.
index = hash(key) % 버킷 수
복잡도
| 연산 | 평균 | 최악 |
|---|---|---|
| 삽입 | O(1) | O(n) |
| 조회 | O(1) | O(n) |
| 삭제 | O(1) | O(n) |
충돌 (Collision)
서로 다른 키가 같은 인덱스로 가는 경우다. 버킷 수보다 키의 가짓수가 훨씬 많으므로 피할 수 없다.
| 처리 방식 | 동작 | 사용 예 |
|---|---|---|
| 체이닝 | 같은 버킷의 항목을 리스트(또는 트리)로 묶음 | Java HashMap (한 버킷이 길어지면 레드-블랙 트리로 전환) |
| 개방 주소법 | 충돌하면 정해진 규칙으로 다른 빈 버킷을 찾아 저장 | Python dict |
적재율과 크기 조정
저장된 항목 수 ÷ 버킷 수를 적재율(load factor)이라 한다. 적재율이 높아지면 충돌이 늘어 느려지므로, 일정 수준(예: 2/3, 0.75)을 넘으면 버킷 배열을 키우고 전체를 다시 배치(rehash)한다. 이 비용 때문에 삽입도 동적 배열처럼 분할 상환 O(1)이다.
최악 O(n)과 해시 플러딩
모든 키가 같은 버킷으로 가면 조회가 리스트 탐색과 같아져 O(n)이 된다. 공격자가 의도적으로 같은 해시를 가진 키를 대량으로 보내 서버를 느리게 만드는 공격이 해시 플러딩(hash flooding) DoS다. 그래서 Python은 문자열 해시에 프로세스마다 다른 무작위 시드를 쓴다(PYTHONHASHSEED). 같은 문자열의 hash() 값이 실행할 때마다 달라지는 이유다.
d = {}
d["banana"] = 3
d["apple"] = 1
d["cherry"] = 2
print(list(d))          # 삽입 순서 유지 (Python 3.7+ 언어 규격)
print("apple" in d)     # 평균 O(1)

try:
    {["list", "as", "key"]: 1}
except TypeError as e:
    print(e)            # 변경 가능한 객체는 키로 쓸 수 없음
['banana', 'apple', 'cherry']
True
unhashable type: 'list'
보강·정정
- “해시 테이블은 순서가 없어 의미 있는 순서로 순회할 수 없다”는 일반론으로는 맞지만, Python
dict는 3.7부터 삽입 순서를 언어 규격으로 보장한다. 다만 정렬 순서는 아니다. 키 순서로 순회하려면 정렬하거나 트리 기반 구조를 쓴다. - 키는 해시 값이 변하지 않아야 한다. 그래서
list처럼 변경 가능한 객체는dict의 키가 될 수 없다. - “데이터베이스 인덱스는 해시 테이블”이라는 설명은 부정확하다. 관계형 DB의 기본 인덱스는 대부분 B+ 트리(6장)다. 해시 인덱스도 있지만 같음(=) 비교에만 쓸 수 있고, 범위 검색(
BETWEEN,>)과 정렬을 지원하지 못해 보조적으로 쓰인다. - 사전(dictionary) 비유는 해시보다 정렬된 목록에서 위치를 좁혀 가는 탐색에 가깝다. 해시 테이블은 “A 섹션 근처”로 가는 것이 아니라 계산된 정확한 칸으로 간다.
해시 테이블의 해시와 암호 해시는 다르다
IAM 업무에서 “해시”는 주로 비밀번호 해시를 뜻하는데, 이것은 해시 테이블의 해시 함수와 목적이 다르다.
| 항목 | 해시 테이블용 해시 함수 | 암호학적 해시 / 비밀번호 해시 |
|---|---|---|
| 목적 | 키를 버킷에 고르게 분산 | 원문 추정·위조를 어렵게 |
| 속도 | 빠를수록 좋음 | 비밀번호 해시는 일부러 느리게 (bcrypt, scrypt, Argon2, PBKDF2) |
| 충돌 | 허용하고 처리함 | 찾기 어려워야 함 |
| 예 | Python hash(), SipHash, MurmurHash |
SHA-256, NT 해시(MD4 기반), Argon2 |
실제 사용처
- Python
dict·set, JavaScriptMap·객체, JavaHashMap - 캐시(Redis, Memcached의 키-값 저장), 세션 저장소(세션 ID → 사용자 정보. 인증 개념 7가지의 서버 세션)
- 중복 제거, 빈도 계산, 조인 연산(해시 조인)
6. 트리 (Tree)
구조와 용어
계층 구조다. 맨 위의 루트(root)에서 시작해 각 노드가 자식(child) 노드를 가진다. 자식이 없는 노드를 리프(leaf), 루트에서 가장 먼 리프까지의 거리를 높이(height)라 한다. 그래프 관점에서 트리는 “사이클이 없고 모든 노드가 연결된 그래프”다.
이진 트리와 이진 탐색 트리 (BST)
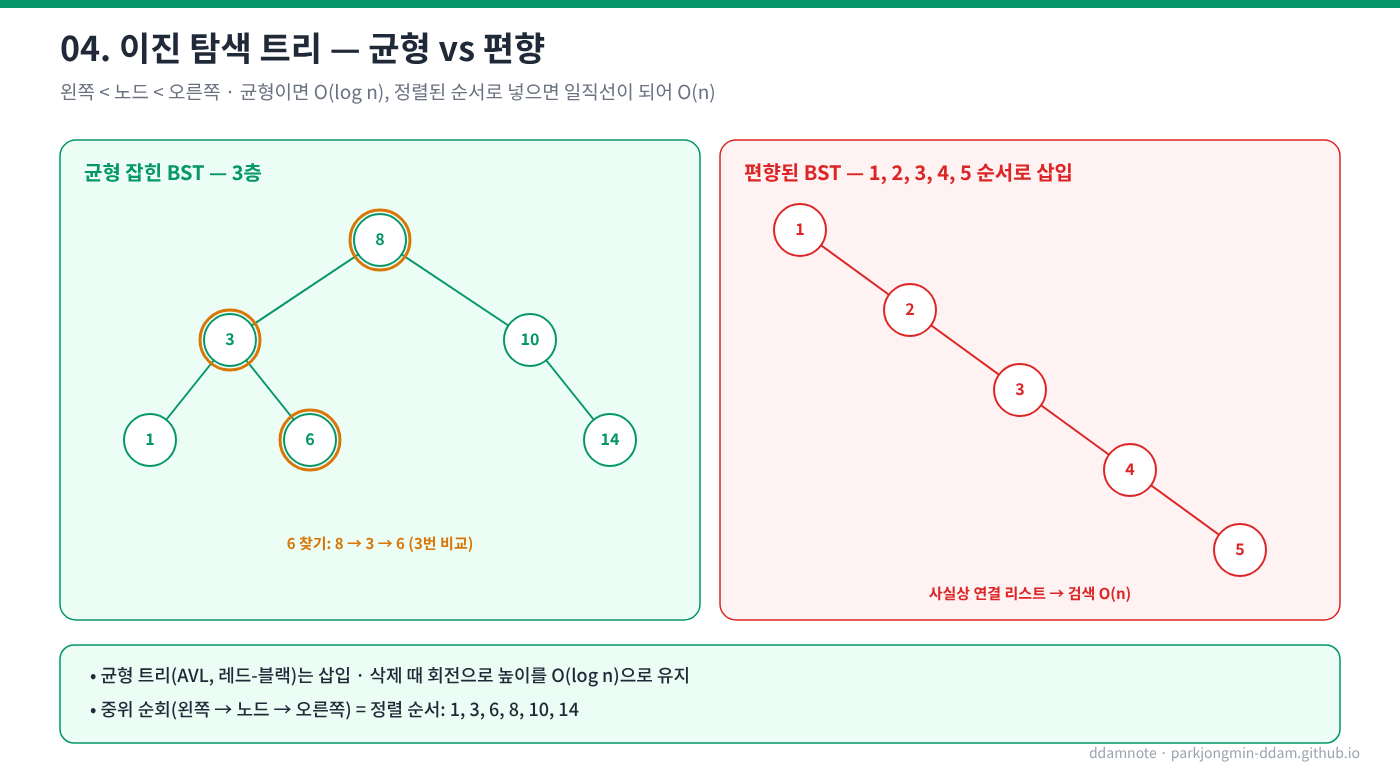
이진 트리는 각 노드의 자식이 최대 2개(왼쪽, 오른쪽)인 트리다. 이진 탐색 트리는 여기에 규칙을 더한다. 모든 노드에서 왼쪽 서브트리의 값은 그 노드보다 작고, 오른쪽은 크다. 비교할 때마다 남은 후보가 절반으로 줄어 검색이 O(log n)이 된다.
| 연산 | 균형 잡힌 BST | 편향된 BST (최악) |
|---|---|---|
| 검색 | O(log n) | O(n) |
| 삽입 | O(log n) | O(n) |
| 삭제 | O(log n) | O(n) |
| 정렬 순서 순회 | O(n) | O(n) |
편향과 균형 트리
이미 정렬된 데이터(1, 2, 3, 4, 5)를 순서대로 BST에 넣으면 모든 노드가 오른쪽 자식만 갖는 일직선이 된다. 사실상 연결 리스트이고 검색이 O(n)으로 떨어진다. 이를 막기 위해 삽입·삭제 때 회전(rotation)으로 높이를 자동 조절하는 균형 트리를 쓴다.
| 균형 트리 | 특징 | 사용 예 |
|---|---|---|
| AVL 트리 | 좌우 높이 차를 1 이하로 엄격히 유지. 검색이 조금 더 빠름 | 읽기 위주 메모리 인덱스 |
| 레드-블랙 트리 | 균형 조건이 느슨해 삽입·삭제 시 회전이 적음 | Java TreeMap, C++ std::map, 리눅스 커널 |
순회
class T:
    def __init__(self, v, l=None, r=None):
        self.v, self.l, self.r = v, l, r

#        8
#      /   \
#     3     10
#    / \      \
#   1   6      14
root = T(8, T(3, T(1), T(6)), T(10, None, T(14)))

def inorder(n):
    return inorder(n.l) + [n.v] + inorder(n.r) if n else []

def preorder(n):
    return [n.v] + preorder(n.l) + preorder(n.r) if n else []

def search(n, x, steps=0):
    if n is None:
        return False, steps
    if x == n.v:
        return True, steps + 1
    return search(n.l if x < n.v else n.r, x, steps + 1)

print("inorder :", inorder(root))    # BST의 중위 순회 = 정렬 순서
print("preorder:", preorder(root))
print("search 6:", search(root, 6))
inorder : [1, 3, 6, 8, 10, 14]
preorder: [8, 3, 1, 6, 10, 14]
search 6: (True, 3)
| 순회 | 순서 | 용도 |
|---|---|---|
| 전위 (pre-order) | 노드 → 왼쪽 → 오른쪽 | 트리 복사, 구조 출력 |
| 중위 (in-order) | 왼쪽 → 노드 → 오른쪽 | BST에서 정렬된 순서 |
| 후위 (post-order) | 왼쪽 → 오른쪽 → 노드 | 하위부터 삭제·크기 계산 (폴더 용량) |
| 레벨 순서 | 위 층부터 차례로 | 너비 우선, 큐 사용 |
보강: B-트리와 B+ 트리
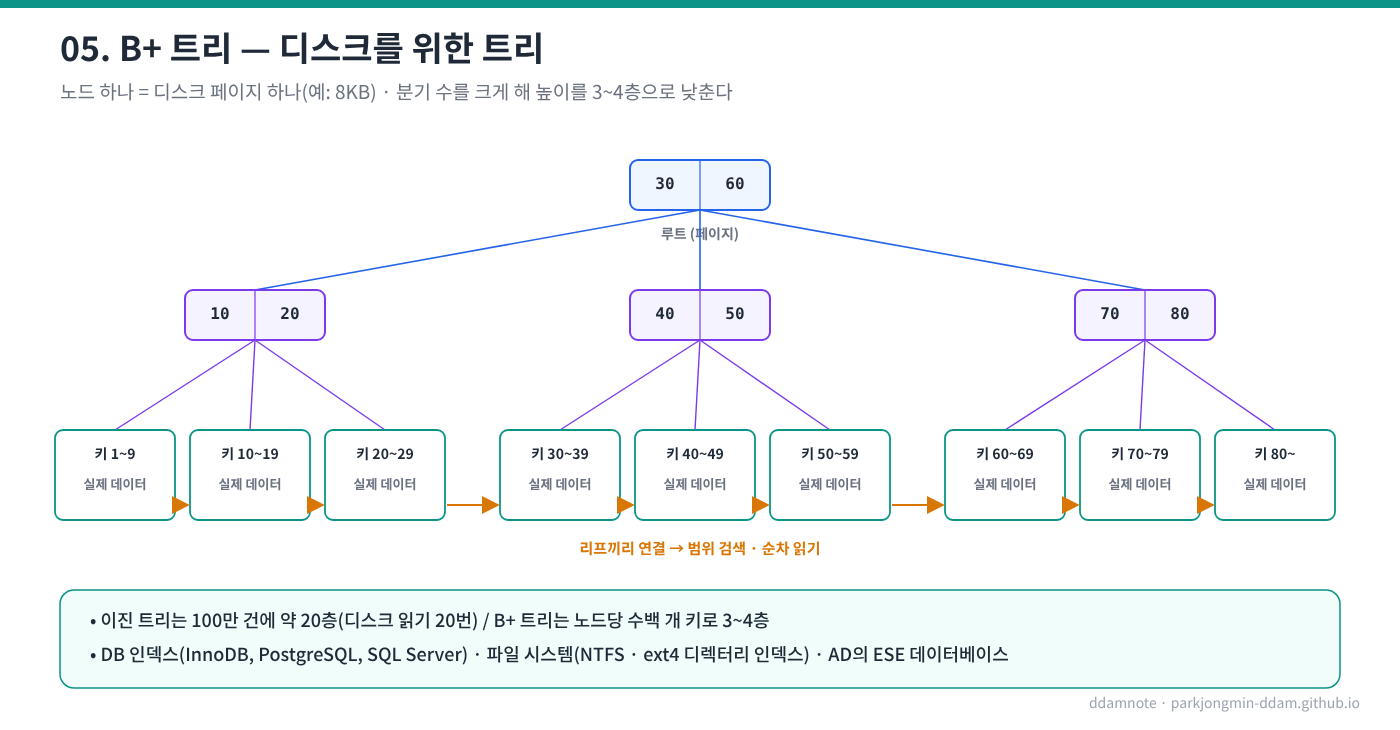
디스크에 저장되는 데이터는 이진 트리로 다루기 어렵다. 노드 하나를 읽을 때마다 디스크 접근이 한 번 일어나는데, 이진 트리는 높이가 높아(100만 건이면 약 20층) 디스크 읽기가 너무 많다. B-트리는 한 노드에 수백 개의 키와 자식을 넣어(높은 분기 수, fan-out) 높이를 3~4층으로 낮춘다. 노드 크기를 디스크 페이지 크기(예: 8KB)에 맞춘다.
B+ 트리는 실제 데이터를 리프 노드에만 두고, 리프끼리 연결 리스트로 이어 범위 검색과 순차 읽기를 빠르게 한 변형이다.
- 관계형 DB 인덱스(MySQL InnoDB, PostgreSQL 기본 인덱스, SQL Server 행 저장 인덱스)
- 파일 시스템(NTFS의 디렉터리 인덱스, ext4의 디렉터리 인덱스, Btrfs)
- Active Directory 데이터베이스(10장)
영상 등에서 흔히 빠지는 구조지만, 실무에서 가장 많이 만나는 트리다.
실제 사용처
- 파일 시스템의 폴더 구조. 다만 하드 링크·심볼릭 링크가 있으면 엄밀히는 트리가 아니라 그래프가 된다.
- HTML DOM, JSON·XML 문서, 프로그래밍 언어의 구문 트리(AST)
- 머신러닝의 결정 트리
- 조직도, 카테고리 분류, DNS 이름 공간, LDAP 디렉터리(10장)
7. 힙 (Heap)
구조
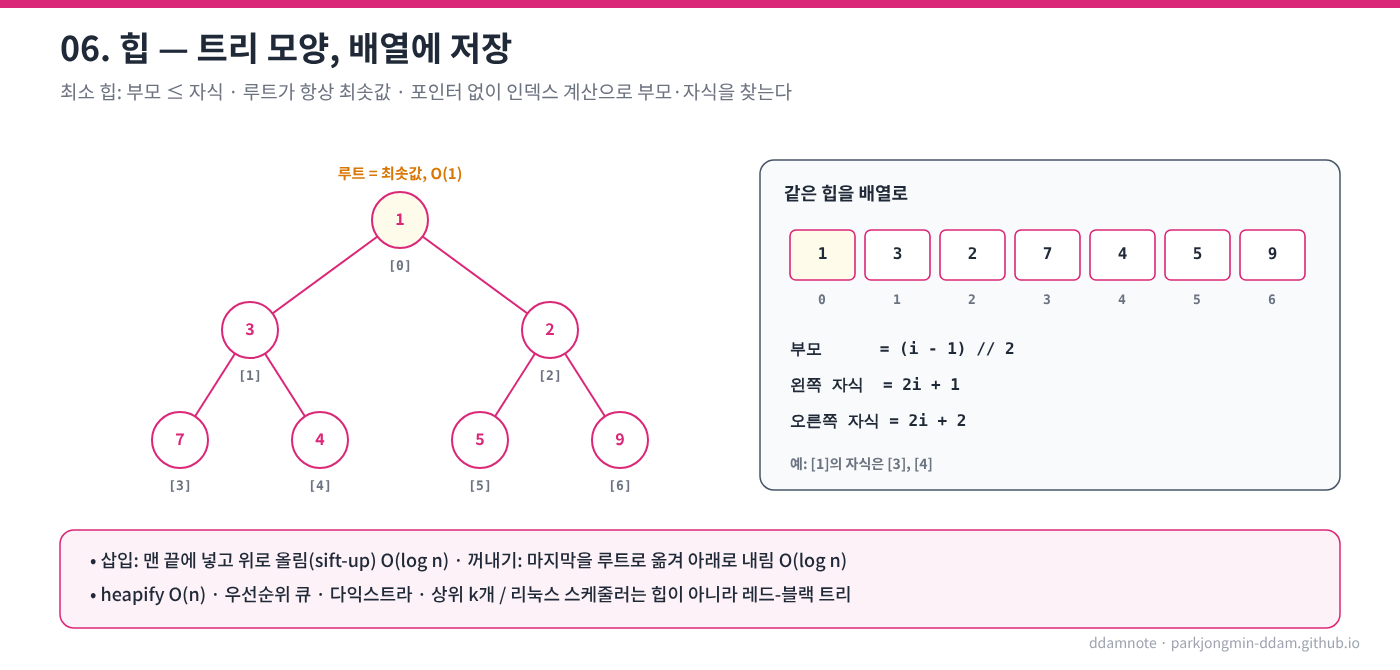
가장 큰 값(최대 힙) 또는 가장 작은 값(최소 힙)이 항상 루트에 있는 완전 이진 트리다. 규칙은 “부모는 자식보다 크다(작다)” 하나뿐이고, 형제 사이나 좌우 순서는 정하지 않는다. BST와 다른 점이다.
완전 이진 트리라서 포인터 없이 배열에 저장할 수 있다. 인덱스 i인 노드의 부모와 자식 위치는 계산으로 구한다.
부모:      (i - 1) // 2
왼쪽 자식: 2i + 1
오른쪽 자식: 2i + 2
복잡도
| 연산 | 복잡도 | 동작 |
|---|---|---|
| 최솟값(최댓값) 확인 | O(1) | 루트를 봄 |
| 삽입 | O(log n) | 맨 끝에 넣고 부모와 비교하며 위로 올림 (sift-up) |
| 최솟값 꺼내기 | O(log n) | 마지막 항목을 루트로 옮기고 아래로 내림 (sift-down) |
| 배열 → 힙 만들기 (heapify) | O(n) | n번 삽입(O(n log n))보다 빠름 |
| 임의 값 검색 | O(n) | 순서 규칙이 약해 탐색에 부적합 |
import heapq

tasks = [(3, "로그 정리"), (1, "장애 대응"), (5, "문서 작성"), (2, "패치 적용")]
heapq.heapify(tasks)                 # O(n), Python heapq는 최소 힙
print(tasks[0])                      # 우선순위가 가장 높은(숫자가 작은) 작업

heapq.heappush(tasks, (0, "보안 경보"))
print([heapq.heappop(tasks)[1] for _ in range(3)])

nums = [42, 7, 19, 88, 3, 56, 71]
print(heapq.nlargest(3, nums))       # 상위 k개: O(n log k)
(1, '장애 대응')
['보안 경보', '장애 대응', '패치 적용']
[88, 71, 56]
실제 사용처
- 우선순위 큐의 표준 구현
- 다익스트라 최단 경로(8장): 아직 확정하지 않은 노드 중 거리가 가장 짧은 것을 매번 꺼냄
- 상위 k개 찾기, 여러 정렬된 파일 병합(외부 정렬)
- 타이머·스케줄러: 가장 먼저 만료될 타이머 찾기
- 힙 정렬: 힙을 만들고 루트를 반복해서 꺼냄, O(n log n)
정정: 운영체제 스케줄러
“운영체제는 다음에 실행할 프로세스를 힙에서 꺼낸다”는 설명은 대표 예시로는 이해할 만하지만, 실제 리눅스는 다르다. 리눅스의 CFS 스케줄러는 실행 대기 작업을 시간 순서로 정렬한 레드-블랙 트리(6장)로 관리했고, 커널 6.6부터 도입된 EEVDF 스케줄러도 레드-블랙 트리를 기반으로 한다. 힙은 최솟값만 빠르고 임의 항목 삭제·갱신이 비싸지만, 스케줄러는 작업의 우선순위 변경과 중간 제거가 잦기 때문이다.
8. 그래프 (Graph)
구조
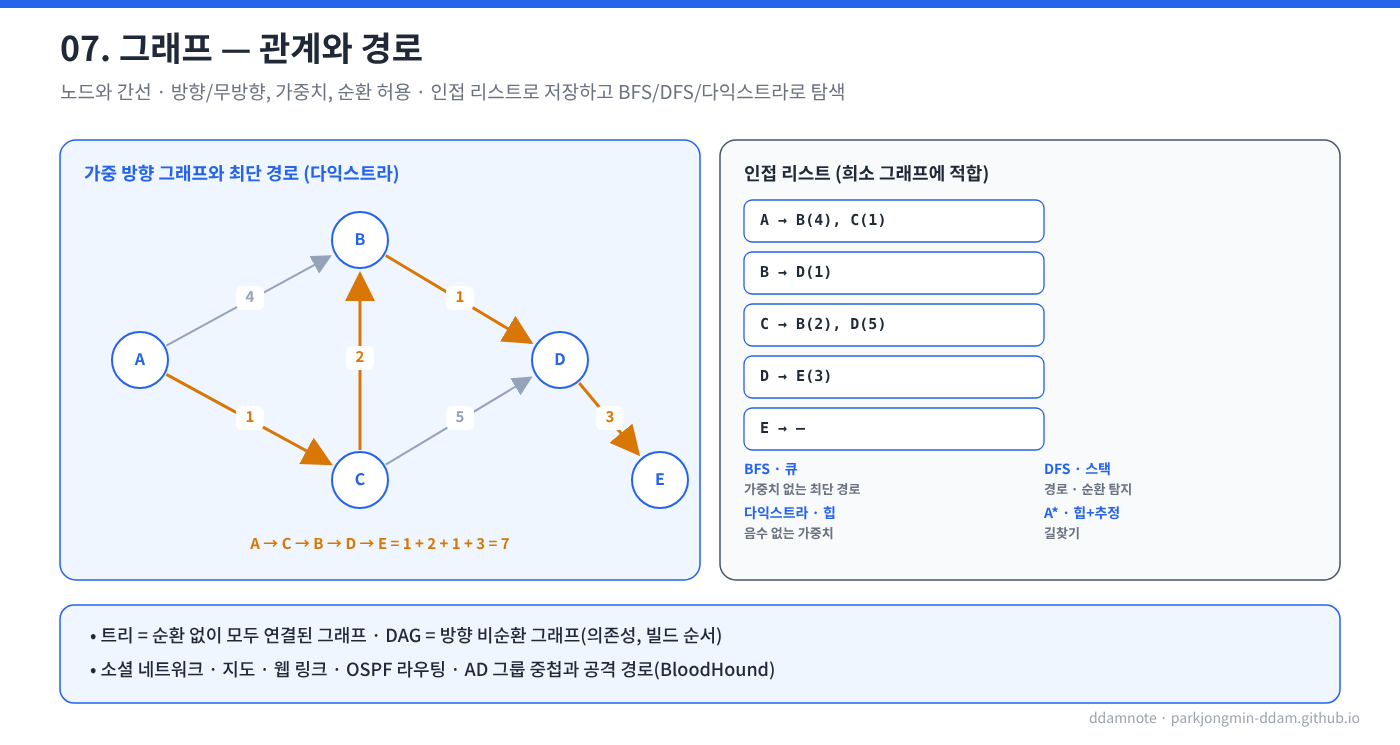
노드(정점, vertex)와 그 사이의 연결(간선, edge)로 이루어진다. 트리와 달리 루트가 없고, 연결이 어느 방향으로든 생길 수 있으며 순환(cycle)도 허용한다. 계층이 아닌 복잡한 관계를 표현하는 가장 일반적인 구조다. 트리, 연결 리스트는 모두 그래프의 특수한 경우다.
| 구분 | 종류 | 예 |
|---|---|---|
| 방향 | 방향 그래프: 간선이 한쪽 방향 | 트위터 팔로우, 웹 링크, AD 그룹 소속 |
| 무방향 그래프: 간선이 양방향 | 페이스북 친구 | |
| 가중치 | 가중 그래프: 간선마다 비용 | 지도의 거리·소요 시간, 네트워크 링크 비용 |
| 순환 | DAG (방향 비순환 그래프) | 작업 의존성, 빌드 순서, Git 커밋 이력 |
표현 방법
| 표현 | 메모리 | 두 노드 연결 확인 | 이웃 나열 | 적합한 경우 |
|---|---|---|---|---|
| 인접 리스트 (노드 → 이웃 목록) | O(V + E) | O(차수) | O(차수) | 간선이 적은 희소 그래프 (대부분의 실제 그래프) |
| 인접 행렬 (V × V 표) | O(V²) | O(1) | O(V) | 간선이 많은 밀집 그래프 |
V는 노드 수, E는 간선 수다.
탐색과 최단 경로
| 알고리즘 | 자료구조 | 용도 | 복잡도 |
|---|---|---|---|
| BFS (너비 우선) | 큐 | 가중치 없는 그래프의 최단 경로(간선 수 기준), 단계별 탐색 | O(V + E) |
| DFS (깊이 우선) | 스택(또는 재귀) | 경로 존재 확인, 순환 탐지, 위상 정렬 | O(V + E) |
| 다익스트라 | 힙 | 음수가 없는 가중치 그래프의 최단 경로 | O((V + E) log V) |
| A* | 힙 + 휴리스틱 | 목표 방향 추정치를 써서 다익스트라보다 탐색 범위 축소 (지도 길찾기) | 휴리스틱에 따라 다름 |
from collections import deque
import heapq

# 무방향, 가중치 없음: BFS로 최소 간선 수 경로
g = {"A": ["B", "C"], "B": ["A", "D"], "C": ["A", "D"], "D": ["B", "C", "E"], "E": ["D"]}

def bfs_path(g, s, t):
    prev, q = {s: None}, deque([s])
    while q:
        u = q.popleft()
        if u == t:
            break
        for v in g[u]:
            if v not in prev:
                prev[v] = u
                q.append(v)
    path, u = [], t
    while u:
        path.append(u)
        u = prev[u]
    return path[::-1]

print("BFS:", bfs_path(g, "A", "E"))

# 가중치 그래프: 다익스트라
w = {"A": {"B": 4, "C": 1}, "B": {"D": 1}, "C": {"B": 2, "D": 5}, "D": {"E": 3}, "E": {}}

def dijkstra(w, s):
    dist, pq = {s: 0}, [(0, s)]
    while pq:
        d, u = heapq.heappop(pq)
        if d > dist[u]:
            continue
        for v, c in w[u].items():
            if d + c < dist.get(v, float("inf")):
                dist[v] = d + c
                heapq.heappush(pq, (d + c, v))
    return dist

print("Dijkstra:", dijkstra(w, "A"))
BFS: ['A', 'B', 'D', 'E']
Dijkstra: {'A': 0, 'B': 3, 'C': 1, 'D': 4, 'E': 7}
A에서 B로 바로 가면 4지만, C를 거치면 1 + 2 = 3이라 더 짧다. 다익스트라는 이런 우회 경로를 찾는다.
실제 사용처
- 소셜 네트워크(사용자 = 노드, 팔로우·친구 = 간선), 추천(“친구의 친구”)
- 지도와 내비게이션(교차로 = 노드, 도로 = 간선, 거리·시간 = 가중치)
- 웹(페이지 = 노드, 링크 = 간선), 검색 엔진의 페이지 중요도 계산
- 네트워크 라우팅 프로토콜(OSPF는 링크 상태로 다익스트라 수행)
- 패키지·빌드 의존성(DAG의 위상 정렬)
- AD 공격 경로 분석(10장)
9. 트라이 (Trie)
구조
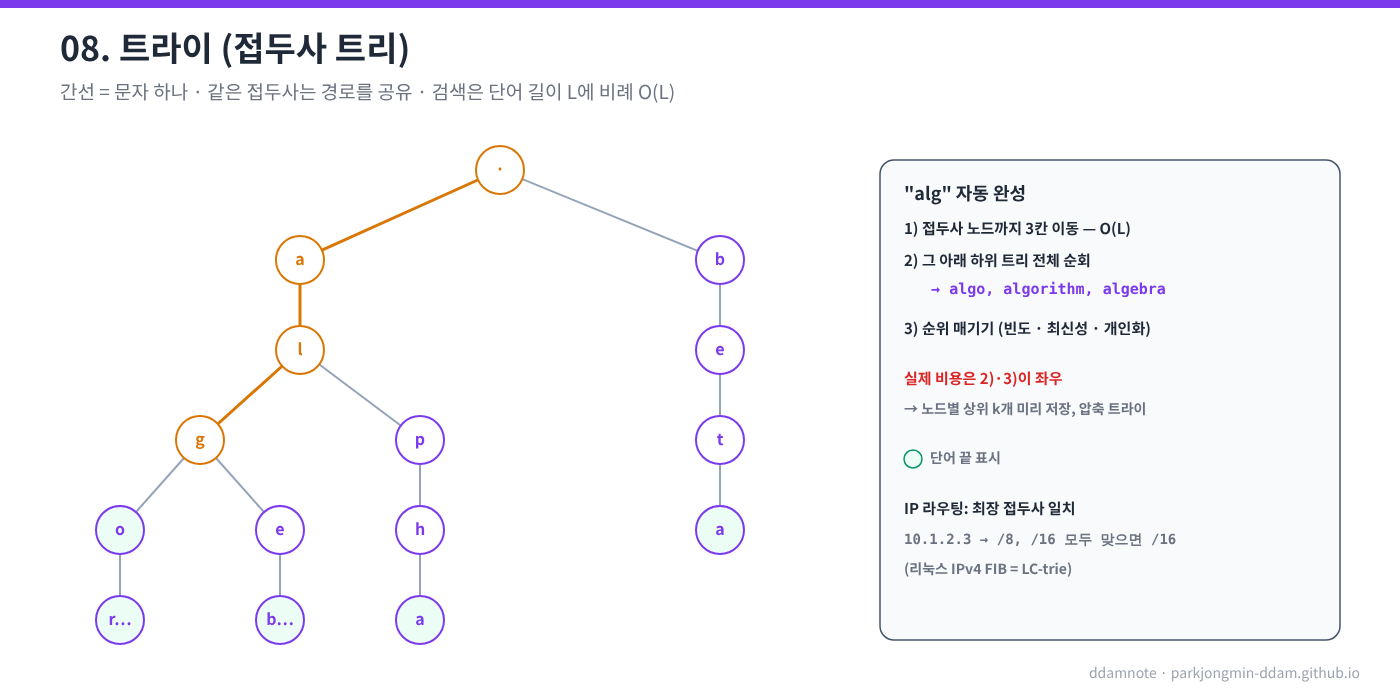
문자열 저장과 검색에 특화된 트리로, 접두사 트리(prefix tree)라고도 한다. 각 간선이 문자 하나를 나타내고, 루트에서 어떤 노드까지의 경로가 하나의 접두사가 된다. 단어가 끝나는 노드에는 끝 표시를 둔다. 같은 접두사를 가진 단어들은 경로를 공유한다.
복잡도
L은 찾는 문자열의 길이다.
| 연산 | 복잡도 |
|---|---|
| 삽입 | O(L) |
| 정확히 일치하는 단어 검색 | O(L) |
| 접두사로 시작하는 단어 존재 여부 | O(L) |
| 접두사로 시작하는 단어 모두 나열 | O(L + 결과에 해당하는 노드 수) |
저장된 단어 수 n과 무관하게 L에만 비례한다는 것이 장점이다.
class Trie:
    def __init__(self):
        self.root = {}

    def insert(self, word):
        node = self.root
        for ch in word:
            node = node.setdefault(ch, {})
        node["$"] = True                 # 단어 끝 표시

    def starts_with(self, prefix):
        node = self.root
        for ch in prefix:                # O(L)
            if ch not in node:
                return []
            node = node[ch]
        out = []
        def walk(n, acc):                # 하위 트리 전체 순회 (결과 수에 비례)
            if "$" in n:
                out.append(prefix + acc)
            for c, child in n.items():
                if c != "$":
                    walk(child, acc + c)
        walk(node, "")
        return out

t = Trie()
for w in ["algo", "algorithm", "algebra", "alpha", "beta"]:
    t.insert(w)
print(t.starts_with("alg"))
print(t.starts_with("x"))
['algo', 'algorithm', 'algebra']
[]
보강·정정: 자동 완성의 실제 비용
“트라이는 1천만 단어든 10단어든 같은 속도”라는 설명은 접두사 노드까지 내려가는 비용에만 해당한다. 자동 완성은 그 아래의 모든 단어를 모으고, 그중 무엇을 먼저 보여 줄지(검색 빈도, 최신성, 개인화) 순위를 매겨야 한다. “a” 한 글자 아래에는 수백만 개의 단어가 있을 수 있다. 실제 시스템은 각 노드에 상위 k개 후보를 미리 저장해 두거나, 트라이를 압축하고 별도의 순위 시스템과 결합한다. 검색 엔진의 추천어가 “트라이를 순회한 결과”라는 설명은 원리 설명으로는 맞지만 실제 구현을 단순화한 것이다.
메모리도 단점이다. 노드마다 자식 표를 가지므로 단어 수가 많으면 메모리 사용량이 크다. 자식이 하나뿐인 노드들을 하나로 합친 압축 트라이(radix tree, Patricia trie)를 많이 쓴다.
실제 사용처
- 검색창·키보드 자동 완성, 맞춤법 검사
- IP 라우팅 테이블: 목적지 주소와 가장 길게 일치하는 접두사(longest prefix match)를 찾는다.
10.1.2.3은10.0.0.0/8과10.1.0.0/16에 모두 맞지만 더 긴/16을 따른다. 리눅스 커널의 IPv4 라우팅 테이블은 압축 트라이(LC-trie)로 구현돼 있다. - DNA 염기 서열 매칭, 사전 기반 토크나이저
10. 인프라·IAM에서 보이는 자료구조
이 주제 자체는 컴퓨터 과학 기초라 AD, ADFS, Azure와 직접 관련된 내용은 아니다. 억지로 연결하지 않고, 실제로 확인되는 지점만 정리했다.
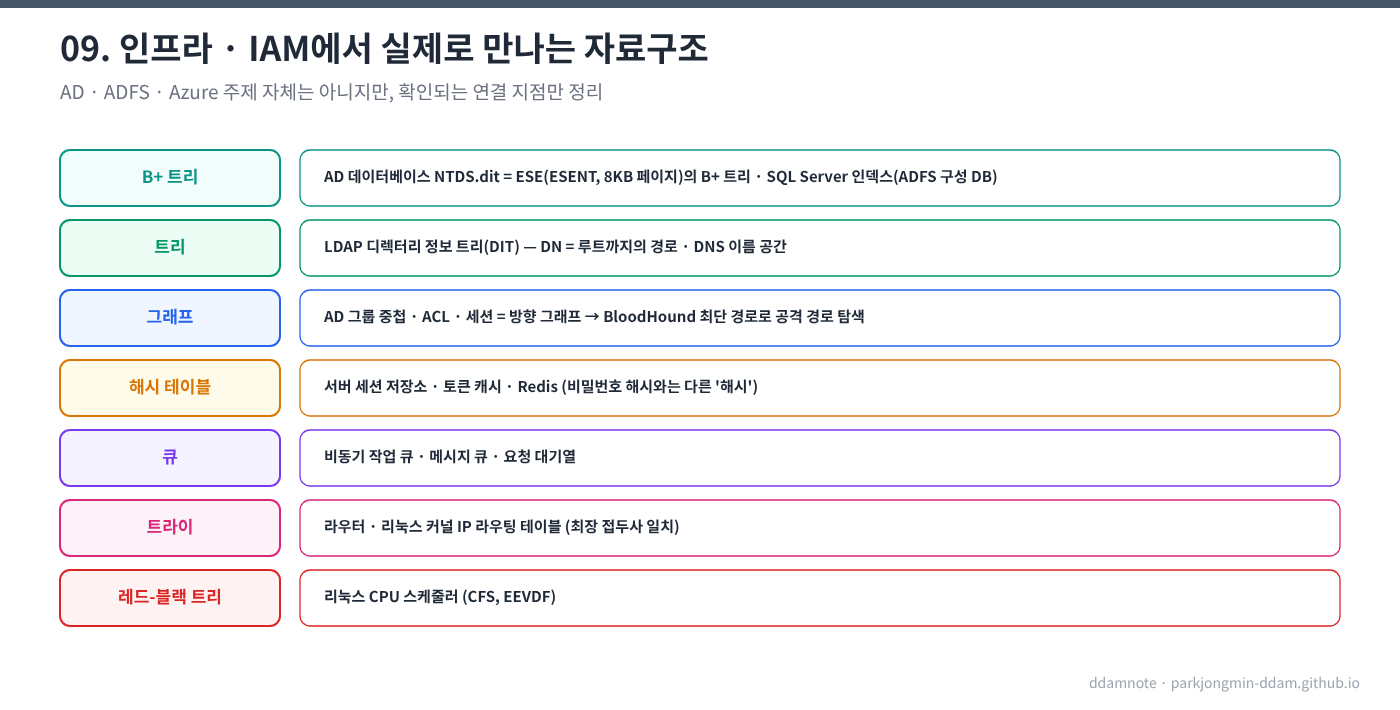
| 자료구조 | 인프라·IAM에서 실제로 쓰이는 곳 | 확인 근거 |
|---|---|---|
| B+ 트리 | AD 데이터베이스 NTDS.dit는 ESE(Extensible Storage Engine) 데이터베이스이고, ESE는 데이터를 B+ 트리로 저장한다. AD가 쓰는 ESENT는 8KB 페이지를 쓴다 |
Microsoft Learn AD DS 데이터베이스 모듈, ESE 아키텍처 문서 |
| 트리 | LDAP 디렉터리 정보 트리(DIT). CN=kim,OU=Users,OU=Seoul,DC=corp,DC=example,DC=com이라는 DN 자체가 루트까지의 경로다 |
LDAP 모델 (RFC 4512) |
| 트리 | DNS 이름 공간. 루트(.) → com → example → corp로 내려가는 계층. AD는 DNS에 의존한다 |
DNS (RFC 1034) |
| 그래프 | AD의 그룹 중첩, 권한(ACL), 세션 관계는 방향 그래프다. BloodHound는 이를 그래프로 저장하고 최단 경로로 “일반 사용자 → Domain Admins” 공격 경로를 찾는다 | BloodHound CE 실습 |
| 해시 테이블 | 서버 세션 저장소, 토큰 캐시, Redis | 인증 개념 7가지 |
| 큐 | 비동기 작업 큐, 메시지 큐 | API 설계 패턴 |
| 트라이 | 라우터·리눅스 커널의 IP 라우팅 테이블 (최장 접두사 일치) | 리눅스 fib_trie |
| 레드-블랙 트리 | 리눅스 CPU 스케줄러 (CFS, EEVDF) | 커널 문서 |
ADFS와 Azure 자체에 대해 이 영상과 직접 연결되는 내용은 없다. 굳이 꼽으면 ADFS 구성 데이터베이스가 WID나 SQL Server에 저장되고, SQL Server의 일반 인덱스가 B+ 트리라는 정도다.
11. 정리
연산별 복잡도
| 자료구조 | 접근 | 검색 | 삽입 | 삭제 | 비고 |
|---|---|---|---|---|---|
| 배열 (동적) | O(1) | O(n) | 끝 O(1)*, 중간 O(n) | 끝 O(1), 중간 O(n) | * 분할 상환 |
| 연결 리스트 | O(n) | O(n) | 위치를 알면 O(1) | 위치를 알면 O(1) | 캐시 효율 낮음 |
| 스택 | 위만 O(1) | O(n) | O(1) | O(1) | LIFO |
| 큐 (deque) | 앞·뒤만 O(1) | O(n) | O(1) | O(1) | FIFO |
| 해시 테이블 | — | 평균 O(1), 최악 O(n) | 평균 O(1) | 평균 O(1) | 순서·범위 검색 없음 |
| 균형 BST | — | O(log n) | O(log n) | O(log n) | 정렬 순서 유지 |
| B+ 트리 | — | O(log n) | O(log n) | O(log n) | 디스크용, 범위 검색 |
| 힙 | 최소·최대 O(1) | O(n) | O(log n) | 루트 O(log n) | 우선순위 큐 |
| 그래프 (인접 리스트) | — | BFS/DFS O(V + E) | O(1) | O(차수) | 관계 표현 |
| 트라이 | — | O(L) | O(L) | O(L) | 접두사 검색 |
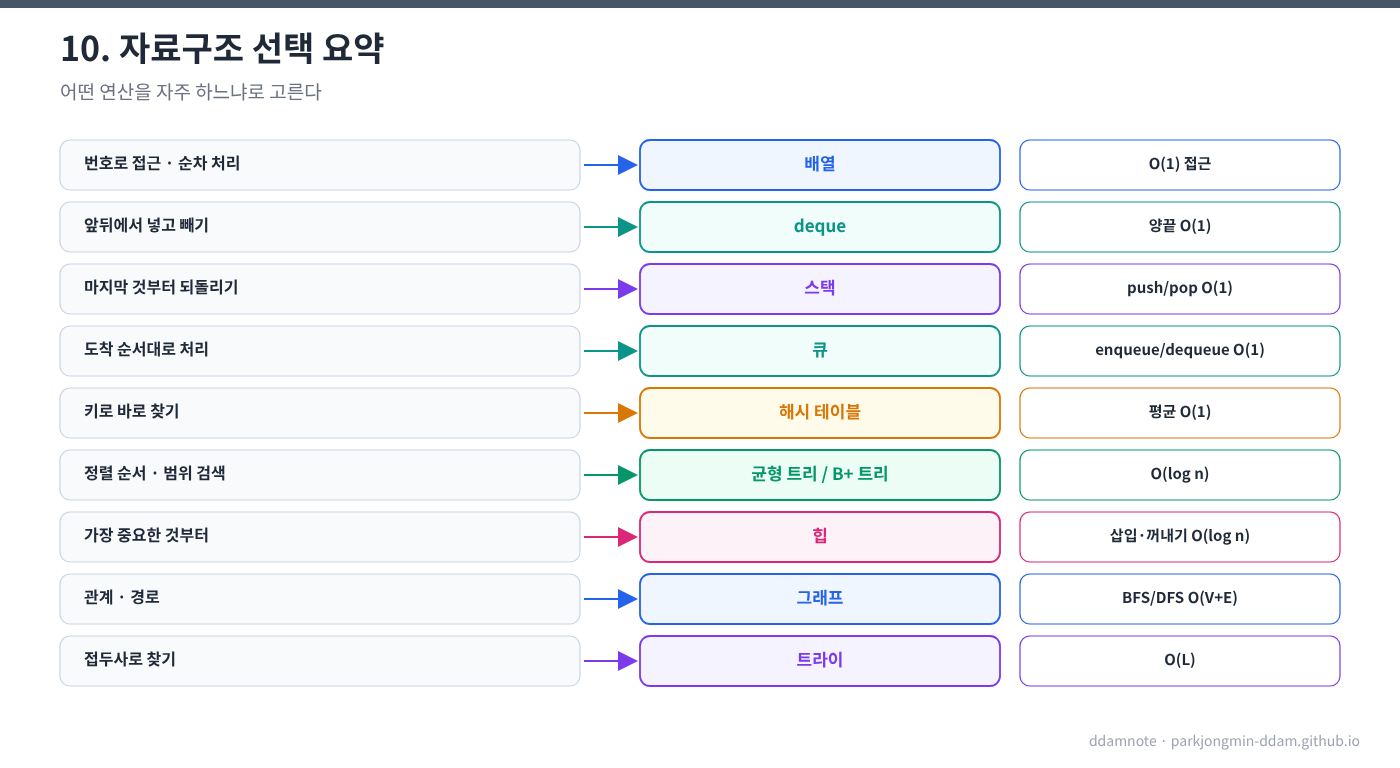
어떤 상황에 무엇을
| 필요한 것 | 선택 |
|---|---|
| 번호로 빠르게 접근, 순차 처리 | 배열 |
| 앞뒤에서 자주 넣고 빼기 | deque |
| 마지막 작업부터 되돌리기 | 스택 |
| 도착 순서대로 처리 | 큐 |
| 키로 바로 찾기 | 해시 테이블 |
| 정렬 순서 유지, 범위 검색 | 균형 트리, (디스크면) B+ 트리 |
| 가장 중요한 것부터 꺼내기 | 힙 |
| 관계와 경로 | 그래프 |
| 접두사로 찾기, 최장 접두사 일치 | 트라이 |
이 글에서 다루지 않은 자료구조
- 집합(Set): 해시 테이블에서 값 없이 키만 둔 것. 중복 제거, 소속 확인
- 스킵 리스트: 연결 리스트에 여러 층의 “급행 링크”를 둬 평균 O(log n) 검색. Redis 정렬 집합(Sorted Set)이 사용
- 블룸 필터: “확실히 없음” 또는 “아마 있음”만 답하는 확률적 구조. 적은 메모리로 소속 여부를 빠르게 거른다. 일부 비밀번호 차단 목록 검사, DB의 불필요한 디스크 읽기 회피에 쓰인다
- 유니온 파인드: 집합의 합치기와 같은 집합 여부 확인. 네트워크 연결 요소, 크러스컬 알고리즘
자료구조는 “어떤 연산을 자주 하느냐”로 고른다. 읽기가 많은지 쓰기가 많은지, 순서가 필요한지, 범위 검색이 필요한지, 데이터가 메모리에 있는지 디스크에 있는지가 선택을 결정한다.
참고
- Python 표준 라이브러리 —
collections.deque,heapq, dict (Mapping Types) - Linux kernel — CFS Scheduler
- Microsoft Learn — Understand the local Active Directory Domain Services database
- Extensible Storage Engine Architecture (B+ 트리, 페이지 구조)
- RFC 4512 — LDAP: Directory Information Models
- RFC 1034 — Domain Names: Concepts and Facilities
Comments