[IAM 개념 정리] 스트랭글러 피그 패턴 — 멈출 수 없는 시스템을 조금씩 교체하는 방법
15년 된 시스템이 회사의 핵심 업무를 돌리고 있다. 느리고, 바꾸기 어렵고, 전체를 이해하는 사람이 남아 있지 않다. 팀은 “처음부터 다시 만들자”고 결정하고, 옛 시스템 개선을 멈춘 채 새 시스템에 매달린다. 6개월, 1년, 2년이 지나는 동안 비즈니스는 계속 새 요구를 내고, 옛 시스템은 그 요구를 받아 계속 변한다. 새 시스템은 움직이는 목표를 쫓다가 결국 중단되고, 옛 시스템은 여전히 돌아간다.
이 글은 그 대안인 스트랭글러 피그(Strangler Fig) 패턴을 정리했다. 개념과 주의사항은 Azure 아키텍처 센터의 패턴 문서를 기준으로 보강했고, 다이어그램은 직접 작성했다. 마지막 장에는 AD FS에서 Microsoft Entra ID로 인증을 옮기는 과정을 이 패턴으로 읽은 IAM 실무 예시를 붙였다. 라우팅 계층으로 쓰이는 구성 요소는 리버스 프록시, 로드 밸런서, API 게이트웨이에서 다뤘다.
1. 전면 재작성이 위험한 이유
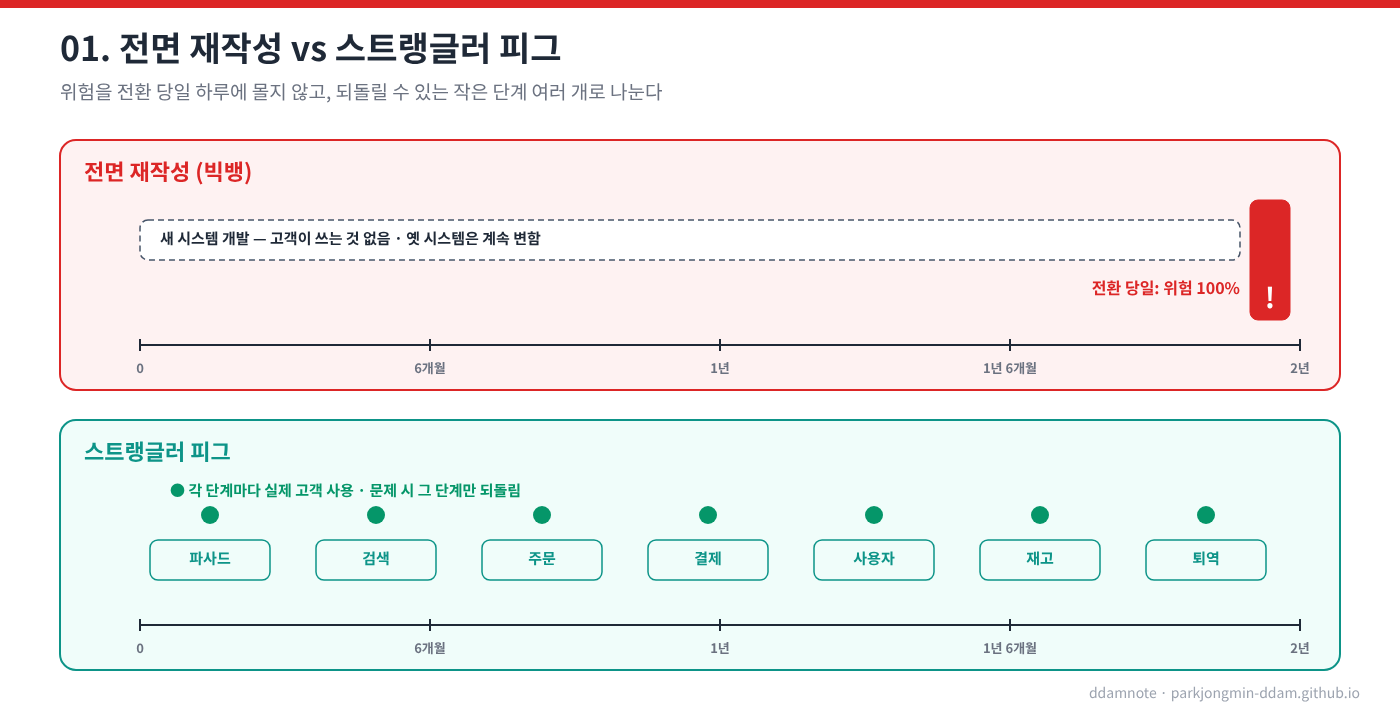
| 항목 | 전면 재작성 (빅뱅) | 스트랭글러 피그 |
|---|---|---|
| 가치 전달 | 완성될 때까지 고객이 쓰는 것 없음 | 첫 기능을 옮긴 날부터 실제 고객이 새 시스템 사용 |
| 요구사항 변화 | 옛 시스템은 계속 변하고 새 시스템이 쫓아감 | 옮긴 기능은 새 시스템에서 바로 변경 |
| 위험 분포 | 전환 당일 하루에 모든 위험 집중 | 기능마다 작은 전환으로 분산 |
| 실패 시 | 수년의 작업 전체가 위험 | 해당 기능만 되돌림 |
| 학습 | 전환 후에야 실제 운영 데이터로 검증 | 단계마다 운영 지표로 검증하고 다음 단계에 반영 |
전면 재작성의 가장 큰 문제는 위험이 한 시점에 몰린다는 것이다. 2년간 만든 모든 기능이 전환 당일에 한꺼번에 맞물려 동작해야 하고, 그중 하나만 틀려도 장애가 된다. 스트랭글러 피그는 이 위험을 작고 되돌릴 수 있는 단계 여러 개로 나눈다.
2. 개념
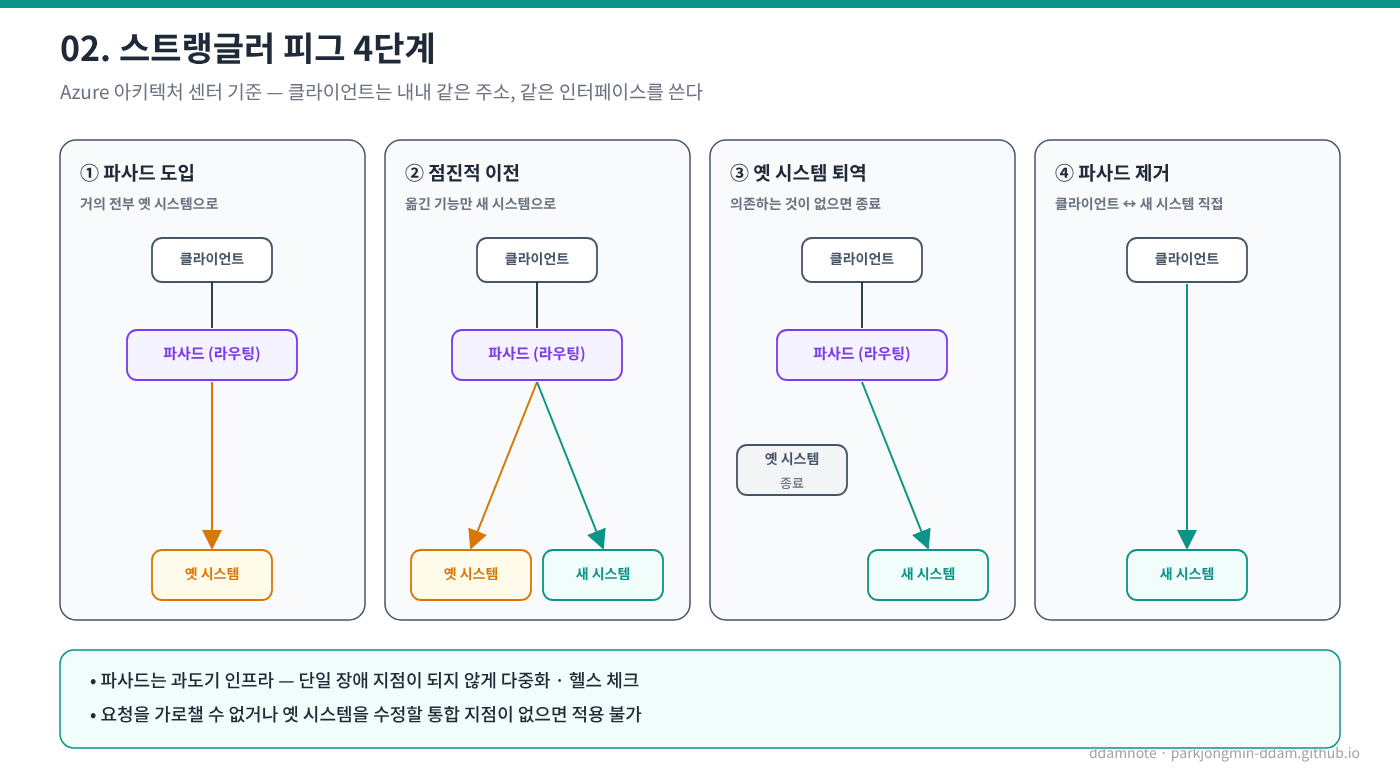
이름은 다른 나무 위에서 싹을 틔워 뿌리를 내리고, 시간이 지나며 원래 나무를 감싸 대체하는 교살무화과(strangler fig)에서 왔다. Martin Fowler가 2004년 글에서 레거시 시스템 교체 방식에 이 이름을 붙였다. 생물학이 아니라 전략이 핵심이다. 기존 시스템을 부수지 않고, 그 주위에 새 시스템을 키워 기존 시스템이 맡던 책임을 하나씩 가져온다.
Azure 아키텍처 센터는 이 과정을 네 단계로 정리한다.
| 단계 | 내용 |
|---|---|
| 1. 파사드 도입 | 클라이언트와 백엔드 사이에 파사드(프록시)를 둔다. 처음에는 거의 모든 요청을 옛 시스템으로 보낸다 |
| 2. 점진적 이전 | 새 시스템에 기능이 구현될 때마다 파사드가 그 기능의 요청을 새 시스템으로 보낸다 |
| 3. 옛 시스템 퇴역 | 모든 기능이 옮겨지고 옛 시스템에 의존하는 것이 없으면 옛 시스템을 끈다 |
| 4. 파사드 제거 | 클라이언트가 새 시스템과 직접 통신한다. 레거시 클라이언트용 어댑터로 남겨 두는 선택도 있다 |
클라이언트는 이 과정 내내 같은 주소, 같은 인터페이스를 쓴다. 이전이 진행 중이라는 것을 알 필요가 없다.
3. 1단계: 파사드(라우팅 계층)를 앞에 둔다
첫 단계에서는 아무것도 다시 만들지 않는다. 옛 시스템 앞에 라우팅 계층만 둔다. 첫날의 라우팅 규칙은 “전부 옛 시스템으로”다. 고객 입장에서는 달라진 것이 없지만, 트래픽을 어디로 보낼지 정할 수 있는 통제점이 생긴다. 이 통제점이 이후 모든 단계를 가능하게 한다.
# 1일차: 전부 모놀리스
location / {
    proxy_pass http://monolith;
}

# 검색 이전 후: 검색만 새 서비스로
location /search {
    proxy_pass http://search-service;
}
location / {
    proxy_pass http://monolith;
}
라우팅 계층은 보통 리버스 프록시나 API 게이트웨이가 맡는다. 모든 요청이 지나가므로 다음을 갖춰야 한다.
- 무상태로 만들고 여러 대로 운영한다. 한 대뿐이면 이전 장치가 새 단일 장애 지점이 된다.
- 헬스 체크와 장애 조치를 둔다.
- 이전 진행에 맞춰 라우팅 규칙을 관리한다. 규칙이 실제 상태와 어긋나면 이미 옮긴 기능의 요청이 옛 시스템으로 가는 일이 생긴다.
- 요청을 가로챌 수 없는 시스템(클라이언트가 백엔드에 직접 연결하는 구조)에는 이 패턴을 그대로 적용할 수 없다.
4. 2단계: 첫 기능을 고른다
가장 크고, 복잡하고, 중요한 기능부터 시작하지 않는다. 첫 이전의 목적은 패턴이 이 시스템에서 동작하는지 확인하고 팀이 절차를 익히는 것이다.
| 기준 | 좋은 후보 | 나쁜 후보 |
|---|---|---|
| 경계 | 입력·출력이 분명함 (상품 검색) | 여러 기능과 얽혀 있음 (주문-재고-결제가 한 트랜잭션) |
| 데이터 | 읽기 위주, 다른 기능이 쓰지 않음 | 여러 기능이 같은 테이블에 쓰기 |
| 실패 영향 | 일시 장애를 감당할 수 있음 | 장애가 곧 매출 손실·데이터 손상 |
| 변경 빈도 | 자주 바뀌어 옮긴 효과가 큼 | 거의 바뀌지 않음 |
새 검색 서비스를 모놀리스 밖에 만들고, 라우팅 규칙 하나를 바꾼다. 검색 요청은 새 서비스로, 나머지는 그대로 모놀리스로 간다. 6개월 뒤가 아니라 오늘부터 실제 고객이 새 시스템을 쓴다.
이후 주문, 결제, 사용자, 재고 순으로 같은 과정을 반복한다. 새 컴포넌트는 처음부터 경계를 분명히 설계해야 한다. 나중에 그 컴포넌트도 같은 방식으로 교체할 수 있어야 하기 때문이다.
5. 트래픽 전환: 두 가지 축
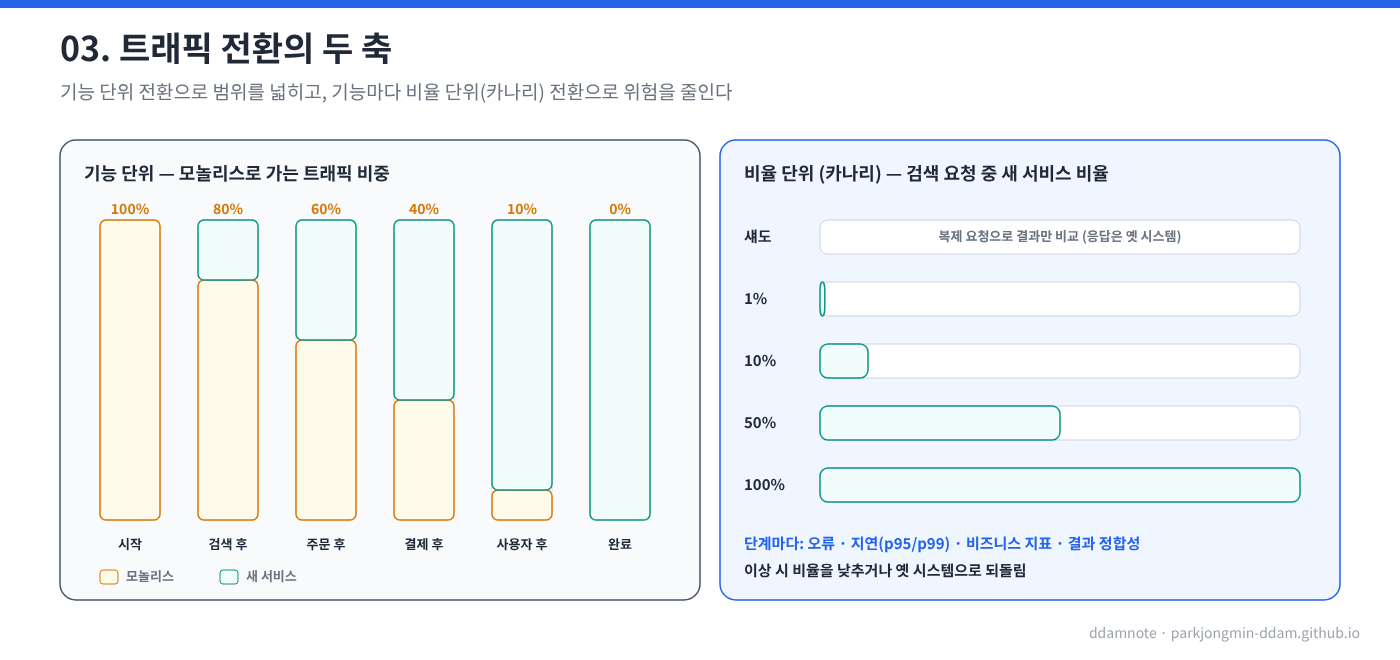
“모놀리스로 가는 트래픽이 100%에서 0%로 줄어든다”는 말에는 서로 다른 두 축이 섞여 있다.
| 축 | 단위 | 예 | 목적 |
|---|---|---|---|
| 기능 단위 전환 | 기능(경로)별 | 검색 이전 후 모놀리스 비중 100 → 80%, 주문 이전 후 60% | 이전 범위를 넓힌다 |
| 비율 단위 전환 (카나리) | 한 기능 안의 요청 비율 | 검색 요청의 1% → 10% → 50% → 100%를 새 서비스로 | 한 기능의 전환 위험을 줄인다 |
기능 하나를 옮길 때마다 그 안에서 비율 단위 전환을 한다. 단계마다 다음을 본다.
| 관측 항목 | 예 |
|---|---|
| 오류 | 5xx 비율, 예외 로그 |
| 지연 | p50·p95·p99 응답 시간 |
| 비즈니스 지표 | 검색 후 클릭률, 주문 전환율 |
| 정합성 | 같은 요청에 대한 옛 시스템과 새 시스템의 결과 차이 |
비율을 올리기 전의 검증
- 섀도 트래픽(parallel run): 실제 요청을 옛 시스템이 처리해 응답하고, 같은 요청을 복제해 새 서비스에도 보낸 뒤 결과만 비교한다. 새 서비스의 응답은 고객에게 가지 않는다. 쓰기 요청은 중복 처리되지 않도록 제외하거나 별도 저장소로 보낸다.
- 기능 플래그: 사용자·조직·지역 단위로 새 서비스 사용 여부를 켜고 끈다. 사내 사용자부터 켜는 식으로 범위를 정한다.
6. 가장 어려운 부분: 데이터
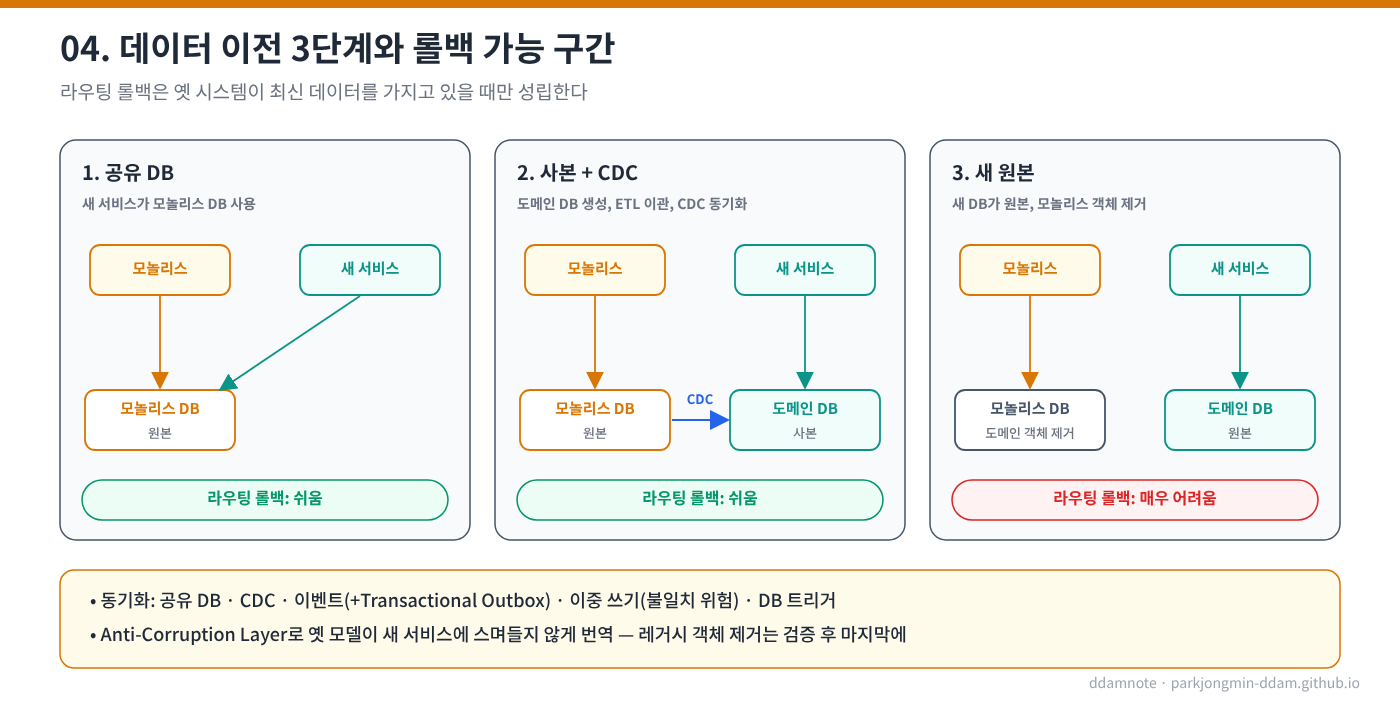
새 검색 서비스는 상품 정보가 필요한데, 그 데이터는 모놀리스의 DB 안에 있다. 코드를 옮기는 것보다 데이터를 옮기는 것이 어려운 경우가 많다. 먼저 다음 질문에 답해야 한다.
- 이 데이터의 소유자(원본, system of record)는 어느 시스템인가
- 새 서비스는 변경을 어떻게 받는가
- 두 시스템이 함께 도는 동안 쓰기는 어디서 일어나는가
단계적 분리
Azure 문서의 데이터베이스 분리 예시는 세 단계다.
| 단계 | 상태 | 원본 |
|---|---|---|
| 1 | 새 서비스가 요청을 받지만 모놀리스 DB를 그대로 사용 | 모놀리스 DB |
| 2 | 도메인 전용 DB를 만들고 ETL로 이관, CDC로 계속 동기화, 정합성 검증 | 모놀리스 DB (새 DB는 사본) |
| 3 | 새 DB가 원본이 되고, 모놀리스에서 해당 도메인 객체 제거 | 새 DB |
동기화 기법
| 기법 | 동작 | 주의 |
|---|---|---|
| 공유 DB | 새 서비스가 모놀리스 DB를 직접 읽음 | 가장 빠른 시작점이지만 스키마 결합이 남음. 1단계용 |
| CDC (변경 데이터 캡처) | DB 트랜잭션 로그를 읽어 변경을 새 저장소로 전달 | 모놀리스 코드를 고치지 않아도 됨. 스키마 변경 대응 필요 |
| 이벤트 발행 | 변경 시 이벤트를 발행하고 새 서비스가 구독 | DB 쓰기와 이벤트 발행이 따로 실패할 수 있음 → Transactional Outbox(같은 트랜잭션으로 outbox 테이블에 기록 후 발행) |
| 이중 쓰기 | 애플리케이션이 두 저장소에 모두 씀 | 한쪽만 성공하면 불일치. 재시도·보정 로직이 필요해 가능하면 피함 |
| DB 트리거 | 저장 프로시저 중심 시스템에서 DB가 직접 메시지 발송 | 애플리케이션 코드를 고칠 수 없을 때 |
Anti-Corruption Layer
새 서비스가 옛 시스템의 데이터나 API를 호출해야 할 때, 그 사이에 번역 계층을 둔다. 옛 시스템의 필드 이름, 코드 값, 이상한 규칙이 새 서비스의 모델에 그대로 스며들지 않게 막는 것이 목적이다. 이 계층이 없으면 새 서비스가 옛 설계를 그대로 복제하게 되고, 이전이 끝나도 같은 문제가 남는다.
데이터 계획 없이 코드만 옮기지 않는다. 애플리케이션을 옮기는 것은 이전의 절반이다.
7. 롤백은 언제까지 쉬운가
“문제가 생기면 라우팅을 되돌리면 된다”는 설명은 조건이 붙는다. 라우팅 롤백은 옛 시스템이 최신 데이터를 가지고 있을 때만 성립한다.
| 데이터 상태 | 라우팅 롤백 | 이유 |
|---|---|---|
| 새 서비스가 모놀리스 DB를 그대로 사용 (6장 1단계) | 쉬움 | 데이터가 한 곳에만 있음 |
| 새 DB는 사본, 원본은 모놀리스 (2단계) | 쉬움 | 옛 시스템의 데이터가 최신 |
| 새 서비스가 자기 DB에 쓰고, 모놀리스로 역동기화 중 | 가능 | 역방향 동기화가 살아 있는 동안만 |
| 새 DB가 원본, 역동기화 없음 | 어려움 | 전환 후 생긴 데이터가 모놀리스에 없음 |
| 모놀리스의 도메인 객체 제거 후 (3단계) | 매우 어려움 | 객체 복원과 변경분 재적용이 필요 |
Azure 문서도 레거시 객체를 제거하기 전까지는 롤백이 단순하지만, 제거한 뒤에는 비용이 크므로 제거는 검증을 마친 뒤 의도적인 마지막 단계로 하라고 권한다. 라우팅 규칙만 보고 “언제든 되돌릴 수 있다”고 판단하면 안 된다.
8. 비용과 위험
병행 운영 비용
이전 기간 동안 옛 시스템과 새 시스템을 함께 운영한다. 아키텍처 두 벌, 모니터링 두 벌, 배포 파이프라인 두 벌이 필요하고, 데이터 동기화까지 운영해야 한다. 옛 코드를 예상보다 오래 유지보수해야 하는 경우도 많다. 파사드도 이전 기간에만 필요한 과도기 인프라다.
가장 큰 위험: 끝내지 못하는 것
검색, 주문, 결제를 옮긴 뒤 이전이 멈추면 시스템은 반은 옛것, 반은 새것인 상태로 남는다. 팀은 두 시스템을 모두 이해하고, 운영하고, 디버깅하고, 배포해야 한다. 줄이려던 복잡도가 그대로 남거나 더 커진다.
이를 막으려면 시작할 때 끝을 정해 둔다.
- 이전 대상 기능 목록과 각 기능의 완료 기준(트래픽 100%, 데이터 원본 이전, 레거시 객체 제거)
- 옛 시스템을 끄는 목표 시점과 그 조건
- 진행률을 기능 수가 아니라 “옛 시스템에 남은 책임” 기준으로 추적
9. 언제 쓰고, 언제 쓰지 않는가
| 쓰는 경우 | 쓰지 않는 경우 |
|---|---|
| 시스템이 크고, 매일 실제 업무를 처리하고, 멈출 수 없음 | 시스템이 작아 다시 만드는 편이 빠름 |
| 이전 기간 동안 옛 시스템이 오래 운영돼야 함 | 잠시 멈추고 한 번에 교체해도 됨 |
| 모놀리스를 서비스로 분해, 외부 구매 시스템 교체, 클라우드로 단계적 이전 | 백엔드로 가는 요청을 가로챌 수 없음 |
| 옛 시스템을 수정할 수 없음 (옮긴 기능을 끄거나 호출을 돌릴 통합 지점이 없음) | |
| 옛 시스템을 빨리 퇴역시켜야 함 | |
| 추가 비용이 시스템 가치보다 큼 |
“작은 서비스가 현대적이라서”는 이유가 되지 않는다. 이 패턴의 추가 비용은 시스템을 멈출 수 없을 때만 정당화된다.
10. IAM 실무 예시: AD FS에서 Entra ID로
AD FS에서 Microsoft Entra ID로 인증을 옮기는 작업은 스트랭글러 피그 패턴의 구조를 그대로 가진다. 인증은 모든 앱과 모든 사용자가 매일 쓰는 시스템이라 멈출 수 없고, 한 번에 바꾸면 전사 로그인 장애로 이어진다. 이전은 두 갈래로 진행된다. 앱(RP)의 인증을 옮기는 것과, 사용자의 로그인 방식을 옮기는 것이다.
앱 인증 이전: 기능 단위 전환
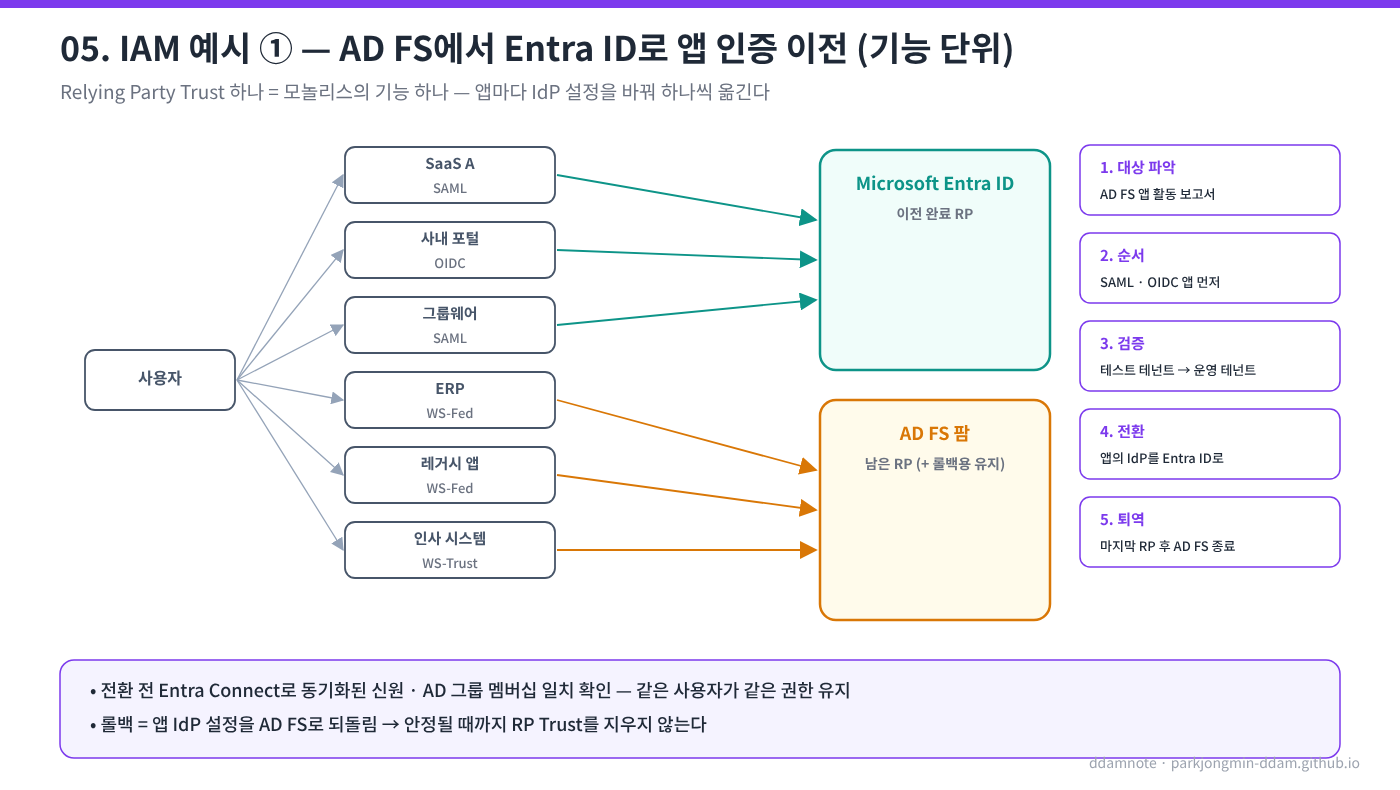
AD FS의 Relying Party Trust 하나하나가 모놀리스의 기능 하나에 해당한다. Microsoft의 이전 가이드를 패턴의 단계에 대응시키면 다음과 같다.
| 패턴의 단계 | AD FS → Entra ID 앱 이전 |
|---|---|
| 대상 파악 | AD FS 애플리케이션 활동 보고서로 실제 사용 중인 앱 식별, Entra Connect Health로 AD FS 모니터링 |
| 첫 기능 선택 | 최신 프로토콜(SAML 2.0, OIDC) 앱부터. 레거시 프로토콜 앱은 Application Proxy나 Secure Hybrid Access 파트너 검토 |
| 섀도·검증 | 테스트 앱 인스턴스를 테스트 테넌트에 연결(선택) → 운영 테넌트에 연결해 운영 사용자로 테스트. Fiddler 등으로 요청·응답 비교 |
| 라우팅 전환 | 운영 앱의 IdP 설정을 Entra ID로 변경 |
| 퇴역 | 마지막 RP까지 옮긴 뒤 AD FS 팜 종료 |
이전 전에 Entra Connect로 동기화된 신원과 AD 그룹 멤버십이 같은지 확인한다. 같은 사용자가 같은 권한을 유지해야 하기 때문이다. 6장의 “데이터 원본과 동기화”가 IAM에서는 “신원과 그룹 정보의 원본과 동기화”가 된다.
롤백 원칙도 같다. 앱의 IdP 설정을 AD FS로 되돌리면 되므로, 전환이 안정될 때까지 AD FS의 해당 RP Trust를 지우지 않고 남겨 둔다. 7장의 “레거시 객체 제거는 검증 후 마지막 단계”와 같은 원리다.
사용자 인증 이전: 비율 단위 전환 (Staged Rollout)
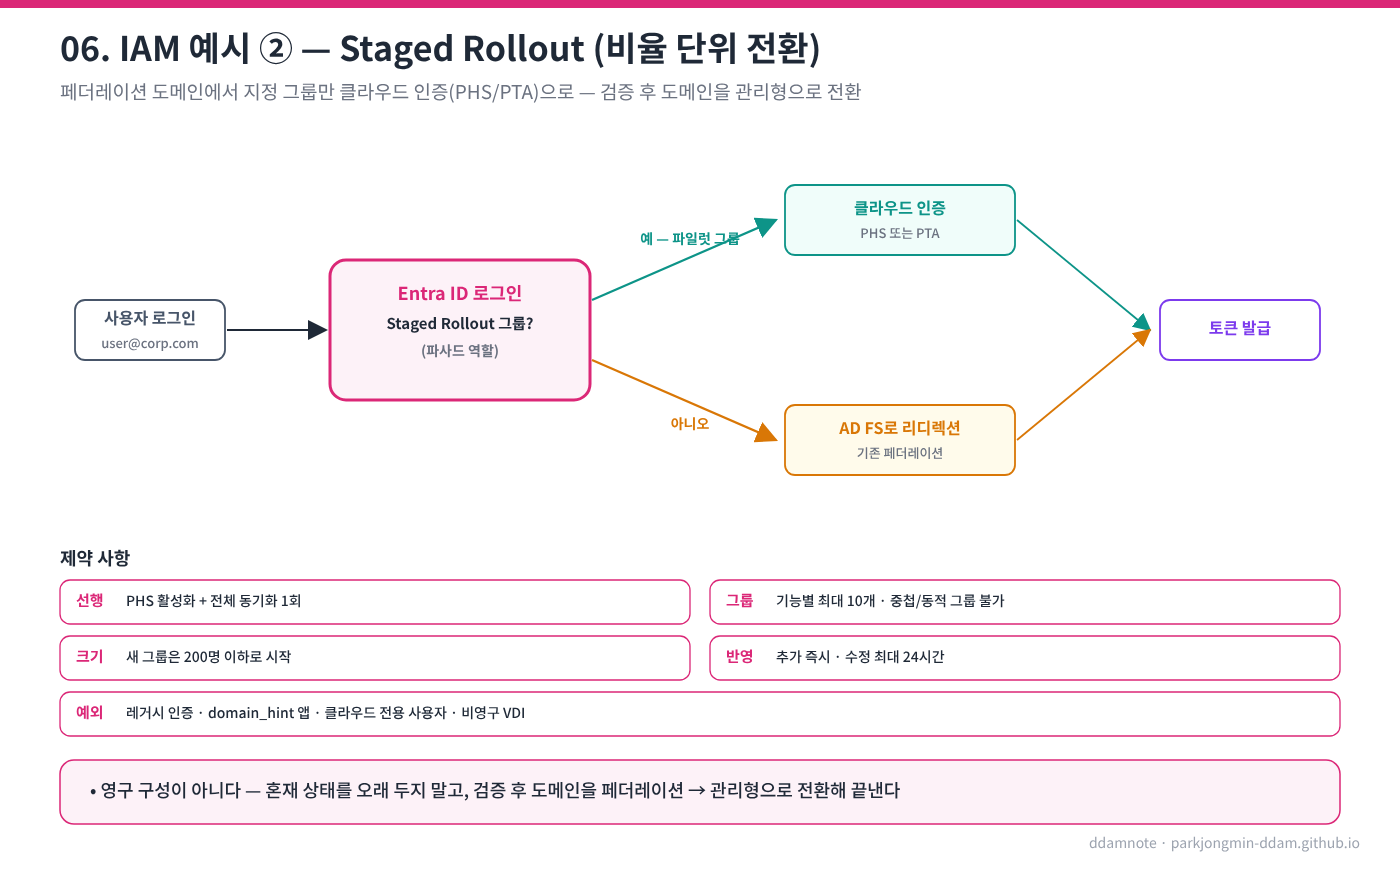
페더레이션 도메인의 사용자는 Entra ID 로그인 시 AD FS로 리디렉션된다. Staged Rollout은 지정한 그룹의 사용자만 AD FS를 거치지 않고 클라우드 인증(PHS 또는 PTA)으로 로그인하게 하는 기능이다. 도메인 전체를 바꾸기 전에 파일럿 그룹으로 검증하는, 5장의 카나리 전환에 해당한다. 이때 Entra ID 로그인 화면이 “이 사용자를 AD FS로 보낼지 클라우드에서 인증할지”를 정하는 파사드 역할을 한다.
| 항목 | 내용 |
|---|---|
| 선행 조건 | 페더레이션 도메인, Entra Connect에서 PHS 활성화와 전체 동기화 1회 완료 (PHS 기반 전환 시) |
| 대상 지정 | 기능(PHS, PTA, Seamless SSO)별 최대 10개 그룹. 중첩·동적 그룹 미지원 |
| 그룹 크기 | 사용자 수 제한은 없지만, 새 그룹은 UX 시간 초과를 피하기 위해 처음 200명 이하로 시작 |
| 반영 시간 | 사용자 추가는 즉시, 멤버십 수정은 최대 24시간 |
| 적용 안 되는 경우 | 레거시 인증(POP3, SMTP 등), domain_hint를 보내는 앱(계속 페더레이션), 클라우드 전용 사용자, 비영구 VDI 등 |
| 끝내는 법 | 검증 후 도메인을 페더레이션에서 관리형(managed)으로 전환 |
Microsoft는 Staged Rollout을 영구 구성으로 쓰지 말고, 일부 사용자는 페더레이션, 일부는 클라우드 인증인 혼재 상태를 오래 유지하지 말라고 안내한다. 예상치 못한 인증 흐름이 생길 수 있기 때문이다. 8장의 “끝내지 못하는 위험”이 인증에서도 그대로 적용된다. 도메인 전환이 2장 4단계 중 “옛 시스템 퇴역”에 해당하는 이전의 끝이다.
정리: 패턴 용어와 IAM 용어
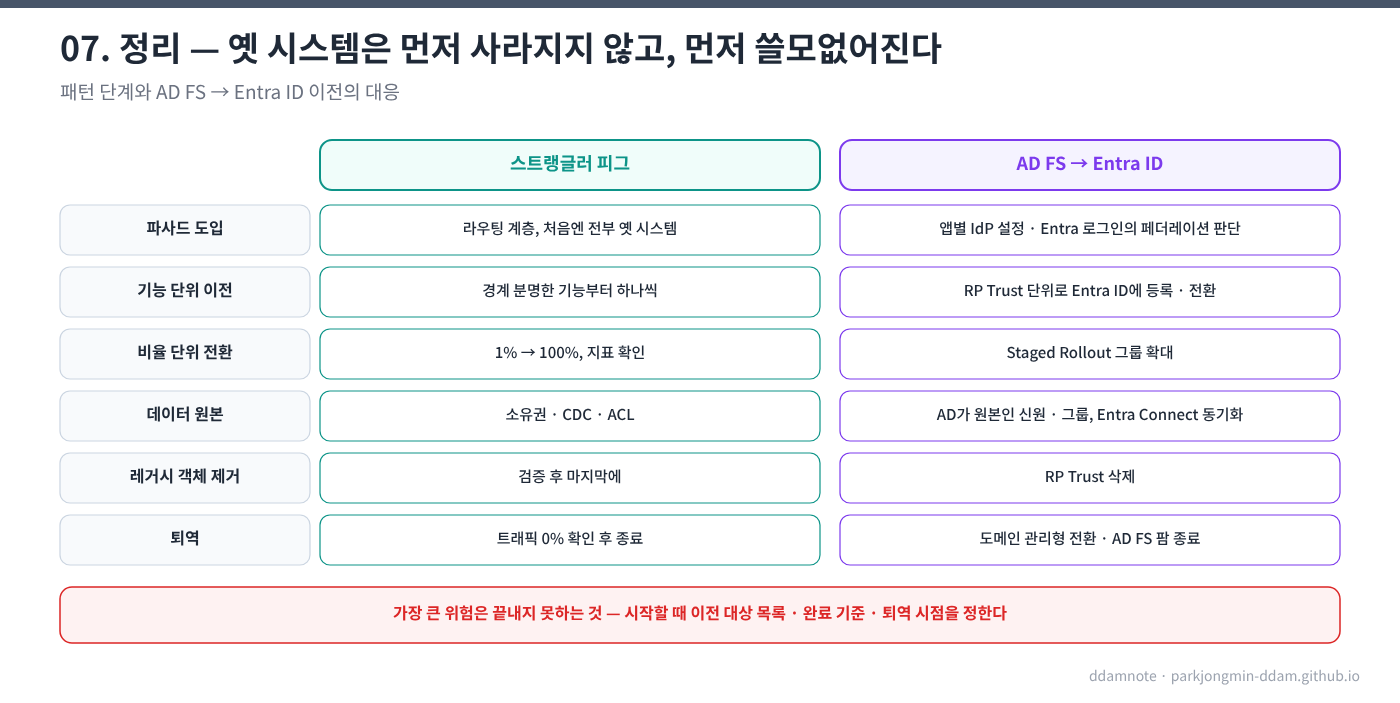
| 스트랭글러 피그 | AD FS → Entra ID |
|---|---|
| 모놀리스 | AD FS 팜 |
| 기능 하나 | Relying Party Trust 하나 |
| 파사드 | 앱별 IdP 설정 / Entra ID 로그인의 페더레이션 판단 |
| 기능 단위 전환 | 앱 단위 IdP 변경 |
| 비율 단위 전환 | Staged Rollout 그룹 확대 |
| 데이터 원본·동기화 | AD가 원본인 신원·그룹, Entra Connect 동기화 |
| 레거시 객체 제거 | RP Trust 삭제 |
| 옛 시스템 퇴역 | 도메인 관리형 전환, AD FS 팜 종료 |
11. 정리
| 단계 | 할 일 | 확인할 것 |
|---|---|---|
| 파사드 도입 | 앞에 라우팅 계층, 처음엔 전부 옛 시스템으로 | 다중화, 헬스 체크 |
| 첫 기능 이전 | 경계가 분명한 기능부터, 비율 단위로 전환 | 오류·지연·비즈니스 지표, 섀도 비교 |
| 데이터 분리 | 공유 DB → 사본 + CDC → 새 원본 | 소유권, 정합성, 롤백 가능 구간 |
| 반복 | 기능마다 같은 절차 | 남은 책임 목록, 끝나는 시점 |
| 퇴역 | 트래픽 0% 확인 후 레거시 객체 제거, 시스템 종료 | 의존하는 것이 정말 없는지 |
| 파사드 정리 | 제거하거나 레거시 클라이언트용 어댑터로 유지 | 과도기 인프라 비용 |
거대한 레거시 시스템 앞에서 “전부 다시 만들자”부터 떠올리지 않는다. 먼저 물어야 할 것은 “안전하게 바꿀 수 있는 첫 번째 조각이 무엇인가”다. 옛 시스템은 먼저 사라지는 것이 아니라, 먼저 쓸모없어진 뒤에 사라진다.
Comments