API 설계 패턴 8가지 정리 — 리소스, 페이지네이션, 멱등성, BFF, 게이트웨이, 비동기, 버전 관리
API는 몇 분이면 만들 수 있습니다. 하지만 요청이 수백만 건으로 늘고, 웹·모바일·외부 파트너가 함께 붙고, 요구사항이 몇 년에 걸쳐 바뀌어도 깨지지 않는 API를 설계하는 것은 별개의 문제입니다. 이 글은 그 과정에서 반복해서 나타나는 문제 여덟 가지와, 각 문제를 해결하는 API 설계 패턴을 순서대로 정리했습니다.
각 패턴의 상세 설명과 주의사항은 RFC 9110(HTTP Semantics)과 IETF HTTPAPI 워킹그룹 문서를 기준으로 정리했고, 다이어그램은 직접 작성했습니다. 앞서 정리한 인증 개념 7가지와 이어지는 내용이 5장(BFF)과 6장(API Gateway)에 있습니다.
예시는 하나의 쇼핑몰 API를 기준으로 합니다. 한쪽에는 웹 앱, 모바일 앱, 외부 파트너가 있고, 다른 쪽에는 사용자·상품·주문·결제 서비스가 있으며, 그 사이에 API가 있습니다. 시스템이 커질수록 이 API는 전체 아키텍처에서 가장 바꾸기 어려운 경계가 됩니다.
1. 리소스 중심 설계 (Resource-Oriented Design)
해결하려는 문제
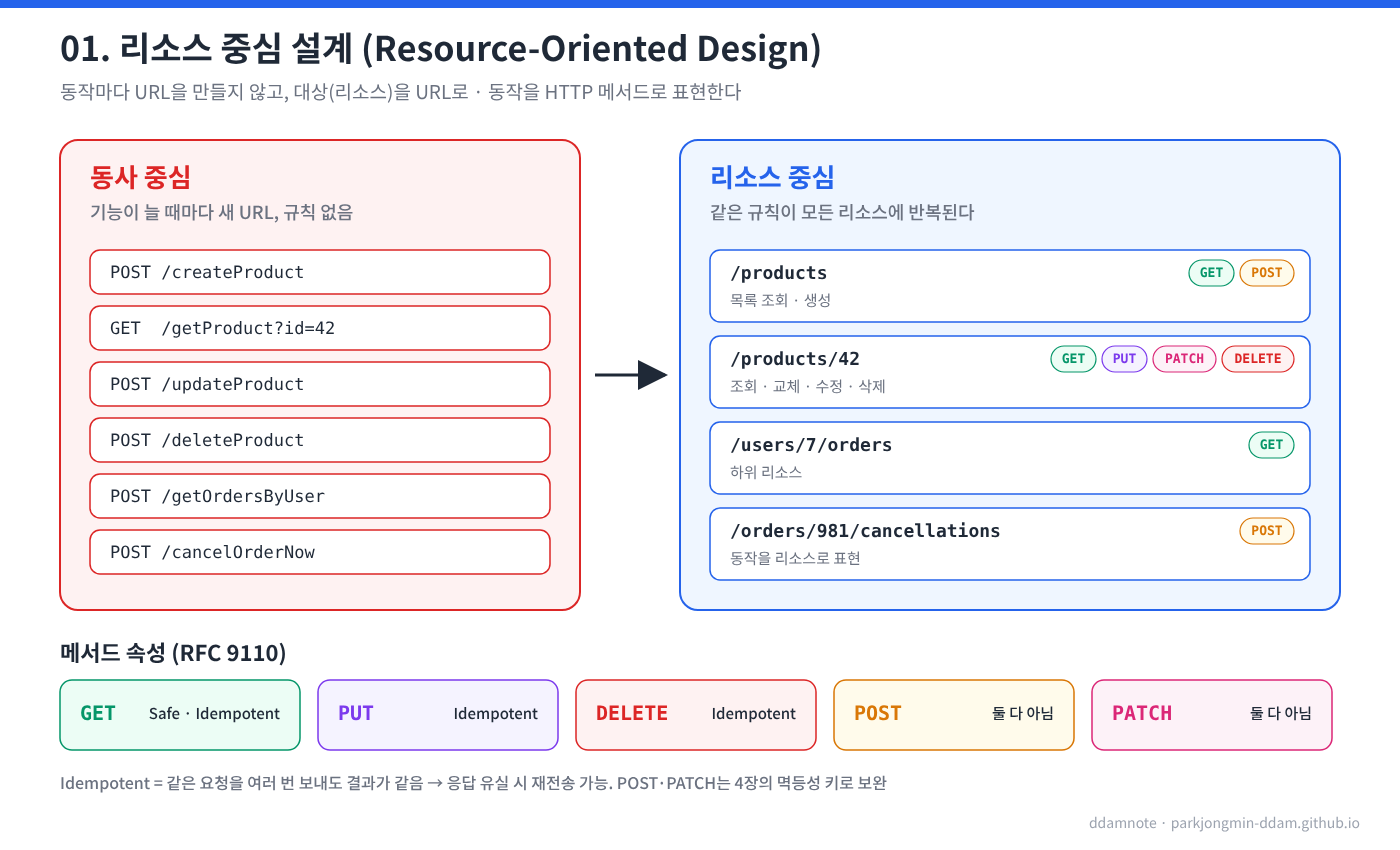
동작(동사) 단위로 API를 만들면 기능이 추가될 때마다 URL이 새로 생깁니다.
POST /createProduct
GET  /getProduct?id=42
POST /updateProduct
POST /deleteProduct
POST /getOrdersByUser
POST /cancelOrderNow
- URL 이름에 규칙이 없어 엔드포인트마다 문서를 따로 읽어야 합니다.
- 같은 “조회”라도 GET/POST가 섞여 있으면 캐시, 재시도, 프록시가 요청의 성격을 판단할 수 없습니다.
- 상품 API를 익혀도 주문 API 사용법을 추측할 수 없습니다.
개념
시스템의 동작이 아니라 시스템이 다루는 대상(리소스)을 기준으로 URL을 설계하고, 무엇을 할지는 HTTP 메서드로 표현합니다.
| 동작 | 동사 중심 | 리소스 중심 |
|---|---|---|
| 목록 조회 | GET /getProducts |
GET /products |
| 생성 | POST /createProduct |
POST /products |
| 단건 조회 | GET /getProduct?id=42 |
GET /products/42 |
| 전체 교체 | POST /updateProduct |
PUT /products/42 |
| 부분 수정 | POST /updateProductPrice |
PATCH /products/42 |
| 삭제 | POST /deleteProduct |
DELETE /products/42 |
| 하위 리소스 | POST /getOrdersByUser |
GET /users/7/orders |
- 컬렉션은 복수 명사(
/products), 개별 항목은 컬렉션 아래 식별자(/products/42)로 둡니다. - 상품 API 구조를 이해하면 주문(
/orders,/orders/981)과 사용자(/users,/users/7)도 같은 규칙으로 예측할 수 있습니다.
HTTP 메서드의 의미
메서드는 이름표가 아니라 클라이언트·프록시·캐시가 믿고 동작하는 약속입니다. RFC 9110은 메서드를 두 가지 속성으로 구분합니다.
| 메서드 | 용도 | Safe | Idempotent | 주요 성공 응답 |
|---|---|---|---|---|
GET |
조회 | O | O | 200 OK |
HEAD |
헤더만 조회 | O | O | 200 OK |
POST |
컬렉션에 생성, 기타 처리 | X | X | 201 Created + Location |
PUT |
전체 교체 (없으면 생성) | X | O | 200 OK / 204 No Content |
PATCH |
부분 수정 (RFC 5789) | X | X | 200 OK / 204 No Content |
DELETE |
삭제 | X | O | 204 No Content |
- Safe: 서버 상태를 바꾸지 않는 메서드입니다. 크롤러나 프리페치가 호출해도 문제가 없어야 합니다.
- Idempotent: 같은 요청을 여러 번 보내도 서버에 남는 결과가 한 번 보낸 것과 같은 메서드입니다. 응답이 유실됐을 때 클라이언트가 안심하고 재전송할 수 있는지가 여기서 결정됩니다.
POST와PATCH는 멱등이 보장되지 않습니다. 이 둘을 안전하게 재시도하는 방법이 4장의 멱등성 키입니다.
생성 요청과 응답 예시입니다.
POST /products HTTP/1.1
Content-Type: application/json

{ "name": "Laptop 14", "price": 899000, "category": "laptop" }
HTTP/1.1 201 Created
Location: /products/42
Content-Type: application/json

{ "id": 42, "name": "Laptop 14", "price": 899000, "category": "laptop" }
상태 코드
| 상황 | 상태 코드 |
|---|---|
| 리소스 없음 | 404 Not Found |
| 요청 형식 오류 | 400 Bad Request |
| 형식은 맞지만 처리할 수 없는 내용 (검증 실패) | 422 Unprocessable Content |
| 현재 상태와 충돌 (이미 취소된 주문 재취소 등) | 409 Conflict |
| 인증 없음 / 권한 없음 | 401 / 403 |
오류 본문 형식은 RFC 9457(Problem Details for HTTP APIs)의 application/problem+json을 쓰면 클라이언트가 오류를 일관되게 처리할 수 있습니다.
동사가 필요해 보이는 경우
“주문 취소”처럼 CRUD로 표현하기 애매한 동작도 있습니다. 선택지는 두 가지입니다.
- 상태 변경으로 표현:
PATCH /orders/981+{ "status": "cancelled" } - 동작 자체를 리소스로 표현:
POST /orders/981/cancellations(취소 요청이라는 기록이 생성됨)
취소 사유, 환불 처리 결과처럼 동작에 별도 기록이 남는다면 두 번째 방식이 자연스럽습니다. 어느 쪽이든 /cancelOrderNow 같은 일회성 URL보다 규칙이 예측 가능합니다.
2. 페이지네이션 (Pagination)
해결하려는 문제
사용자가 10명일 때는 GET /users가 전체를 반환해도 문제가 없습니다. 1만 명, 1천만 명이 되면 응답이 수백 MB가 되고, 서버는 메모리와 DB 부하를, 클라이언트는 다운로드와 렌더링 시간을 감당하지 못합니다. 그래서 컬렉션 API는 처음부터 전체를 반환하지 않고 한 번에 일부만 반환하도록 설계합니다.
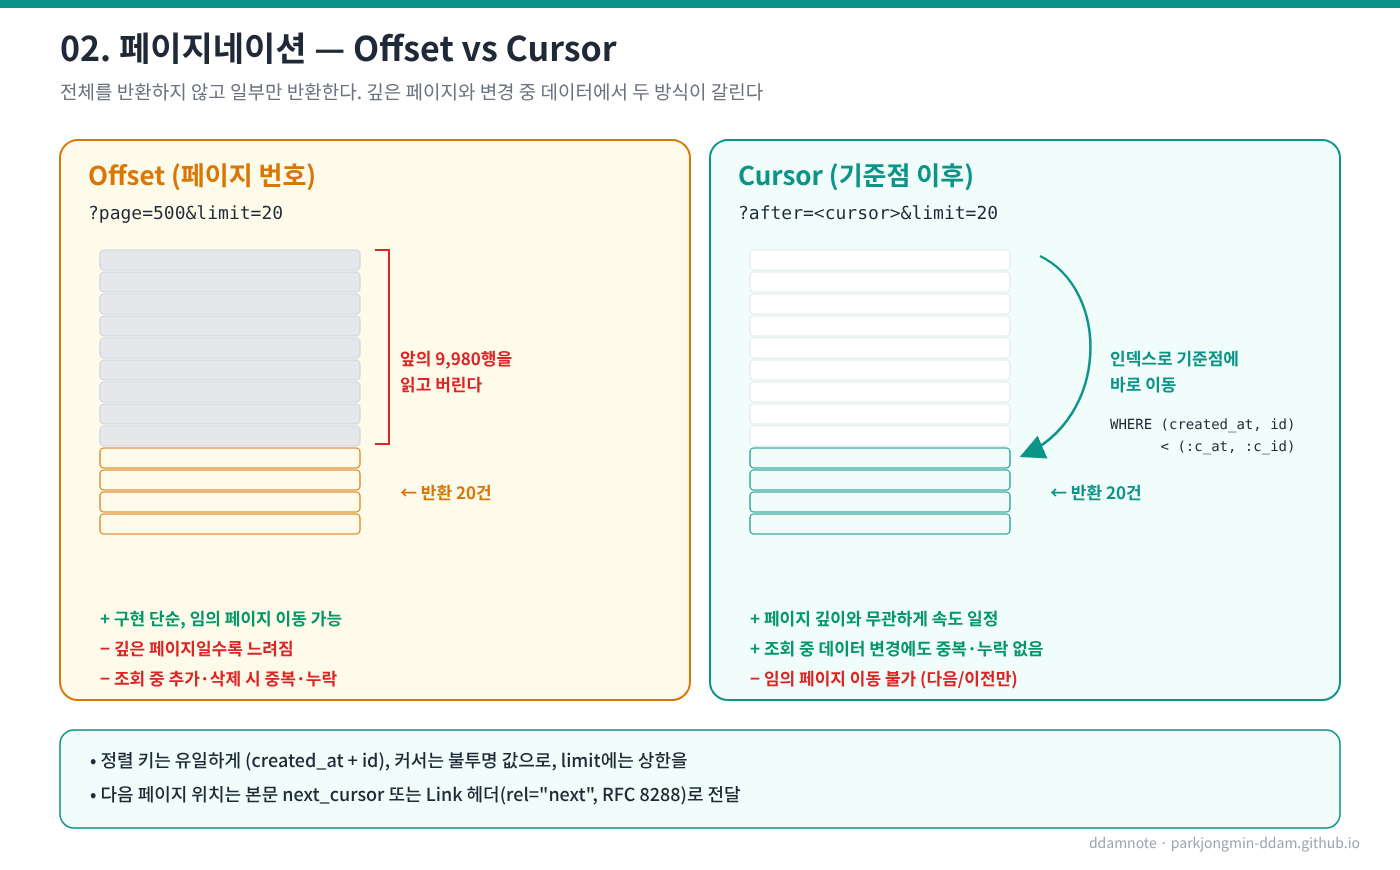
Offset(페이지 번호) 방식
GET /products?page=2&limit=20
SELECT * FROM products
ORDER BY created_at DESC, id DESC
LIMIT 20 OFFSET 20;
- 구현이 단순하고, “3페이지로 이동”처럼 임의 페이지 접근이 가능합니다.
- 깊은 페이지일수록 느려집니다.
OFFSET 199980이면 DB는 앞의 199,980행을 읽고 버린 뒤 20행을 반환합니다. - 조회 도중 데이터가 바뀌면 결과가 어긋납니다. 1페이지를 본 사이에 새 상품이 1건 추가되면 1페이지의 마지막 항목이 2페이지 첫 항목으로 다시 나타나고, 삭제되면 1건이 누락됩니다.
Cursor 방식
“500페이지를 달라”가 아니라 “이 지점 이후 20건을 달라”고 요청합니다. 커서는 마지막으로 받은 항목의 정렬 키입니다.
GET /products?limit=20&after=eyJjIjoiMjAyNi0xMC0xOVQxMDowMDowMFoiLCJpIjo5ODF9
SELECT * FROM products
WHERE (created_at, id) < ('2026-10-19T10:00:00Z', 981)
ORDER BY created_at DESC, id DESC
LIMIT 20;
HTTP/1.1 200 OK
Link: <https://api.example.com/products?limit=20&after=eyJjIjoi...>; rel="next"
Content-Type: application/json

{
  "data": [ ... 20건 ... ],
  "next_cursor": "eyJjIjoiMjAyNi0xMC0xOFQyMzo1OTowMFoiLCJpIjo5NjJ9",
  "has_more": true
}
- 인덱스(
created_at, id)를 타고 시작 지점으로 바로 이동하므로 몇 번째 페이지든 속도가 일정합니다. - 기준점이 값이므로 조회 중 데이터가 추가·삭제돼도 중복이나 누락이 생기지 않습니다.
- 임의 페이지 이동(“37페이지로”)은 할 수 없고, 다음·이전으로만 이동합니다.
구현 시 주의사항
- 정렬 키가 유일해야 합니다.
created_at만 쓰면 같은 시각에 생성된 행 사이에서 경계가 흔들리므로id같은 유일 키를 보조 정렬 키로 붙입니다. - 커서는 불투명(opaque) 값으로 다룹니다. 내부 값을 Base64 등으로 인코딩해 전달하고, 클라이언트가 내용을 해석하거나 조립하지 않도록 문서화합니다. 그래야 서버가 정렬 기준을 바꿔도 클라이언트가 깨지지 않습니다.
- 커서에는 정렬 조건과 필터 조건이 묶여 있으므로, 다른 필터와 섞어 쓰면 거부합니다.
limit에는 상한을 둡니다(예: 최대 100). 상한이 없으면limit=1000000으로 페이지네이션이 무력화됩니다.- 다음 페이지 링크는 본문(
next_cursor)이나 RFC 8288의Link헤더(rel="next")로 전달합니다. - 전체 건수(
total_count)는 대용량 테이블에서 매번COUNT(*)를 실행하므로 비쌉니다. 꼭 필요할 때만 제공합니다.
비교
| 항목 | Offset | Cursor |
|---|---|---|
| 요청 형식 | page=2&limit=20 |
after=<cursor>&limit=20 |
| 깊은 페이지 성능 | 느려짐 (앞 행을 모두 스캔) | 일정 (인덱스 탐색) |
| 데이터 변경 중 일관성 | 중복·누락 발생 | 유지 |
| 임의 페이지 이동 | 가능 | 불가 (다음/이전만) |
| 적합한 화면 | 관리자 화면, 페이지 번호 UI | 무한 스크롤, 피드, 대량 동기화·내보내기 |
3. 필터링, 정렬, 필드 선택
해결하려는 문제
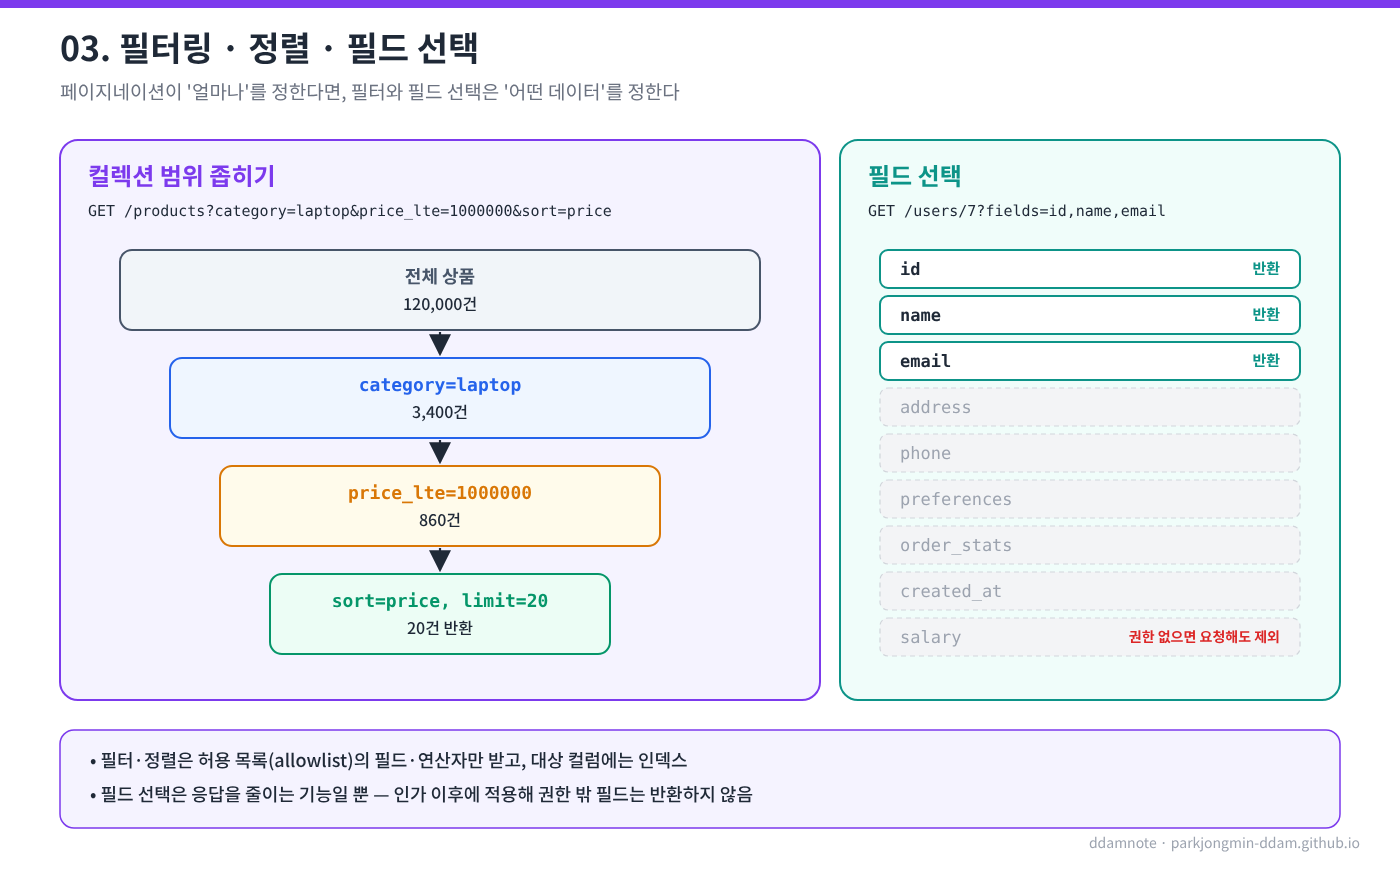
페이지네이션은 “얼마나 많이” 받을지를 정합니다. 남은 질문은 “어떤 데이터를” 받을지입니다. 클라이언트가 “100만 원 이하 노트북을 가격순으로” 보고 싶은데 API가 전체 상품만 준다면, 클라이언트가 모든 페이지를 내려받아 직접 걸러야 합니다.
컬렉션 필터링과 정렬
GET /products?category=laptop&price_lte=1000000&sort=price&limit=20
GET /products?category=laptop&sort=-price            # 내림차순
GET /orders?status=paid&created_gte=2026-10-01
- 필터·정렬은 서버(DB)에서 처리되므로 네트워크로 오가는 데이터가 결과 건수만큼으로 줄어듭니다.
- 필터 문법은 API 전체에서 하나로 통일합니다. 예: 범위는
_gte/_lte접미사, 내림차순은-접두사.
필드 선택 (Sparse Fieldsets)
같은 문제가 객체 하나 안에서도 생깁니다. 사용자 레코드에 주소, 설정, 통계 등 수십 개 필드가 있어도 목록 화면은 이름과 이메일만 필요합니다.
GET /users/7?fields=id,name,email
{ "id": 7, "name": "Kim", "email": "kim@example.com" }
- 응답 크기가 줄어 모바일 환경에서 특히 효과가 큽니다.
- 연관 리소스를 함께 받는 확장(
?expand=customer)도 같은 계열입니다. 기본 응답은 작게, 필요한 경우만 확장합니다. - 클라이언트마다 필요한 필드 조합이 크게 다르고 자주 바뀐다면 GraphQL처럼 클라이언트가 응답 형태를 지정하는 방식이 대안이 됩니다.
주의사항
- 허용 목록(allowlist)만 받습니다. 필터·정렬 가능한 필드와 연산자를 정해 두고, 나머지는
400으로 거부합니다. 쿼리 파라미터를 SQL에 그대로 이어 붙이면 SQL 인젝션이 됩니다. - 필터·정렬 대상 컬럼에는 인덱스를 둡니다. 인덱스 없는 컬럼 정렬을 열어 두면 요청 하나로 전체 테이블 정렬이 실행됩니다.
- 필드 선택은 인가 이후에 적용합니다.
fields=id,name,salary를 요청해도 호출자에게salary열람 권한이 없으면 반환하지 않아야 합니다. 필드 선택은 응답을 줄이는 기능이지, 권한을 넓히는 기능이 아닙니다. - 쿼리 파라미터 조합이 다양해지면 캐시 적중률이 떨어집니다. 캐시 키에 정규화된 쿼리 문자열을 포함합니다.
4. 멱등성 (Idempotency)
해결하려는 문제: 이중 결제
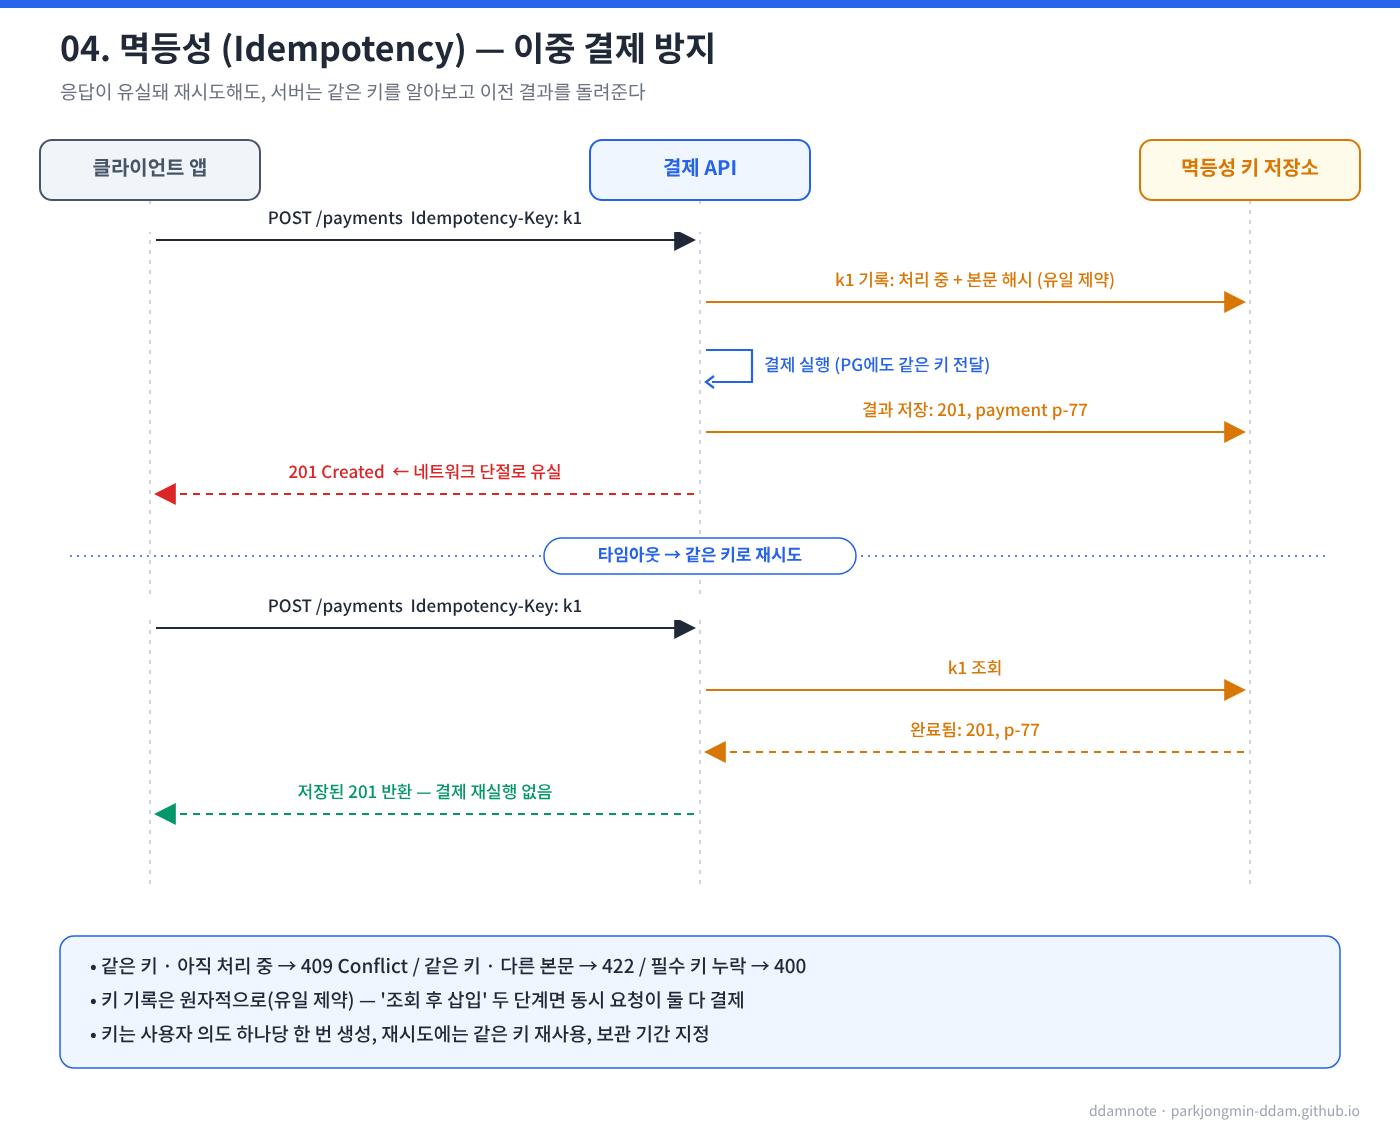
- 사용자가 결제 버튼을 누릅니다.
- 요청이 서버에 도착하고 결제가 성공합니다.
- 응답을 돌려주는 도중 네트워크가 끊깁니다.
- 클라이언트는 성공 여부를 모르므로 같은 요청을 다시 보냅니다.
- 서버는 새 요청으로 보고 다시 결제합니다.
클라이언트 입장에서는 “요청이 서버에 도착하지 않았다”와 “도착해서 처리됐는데 응답만 유실됐다”를 구분할 수 없습니다. 타임아웃 후 재시도는 정상적인 동작이므로, 서버가 중복 요청을 구분할 수 있어야 합니다.
메서드 멱등성과의 관계
1장에서 본 것처럼 GET, PUT, DELETE는 정의상 멱등입니다. DELETE /orders/981을 두 번 보내도 결과는 “981번 주문이 없음”으로 같습니다. 문제는 POST입니다. POST /payments는 보낼 때마다 새 결제를 만들 수 있습니다. 멱등성 키는 POST와 PATCH에 멱등성을 부여하는 장치입니다.
멱등성 키 (Idempotency-Key)
클라이언트가 작업 하나마다 고유한 키를 만들어 요청 헤더에 넣고, 재시도할 때도 같은 키를 다시 보냅니다.
POST /payments HTTP/1.1
Idempotency-Key: "8e03978e-40d5-43e8-bc93-6894a57f9324"
Content-Type: application/json

{ "order_id": 981, "amount": 899000 }
IETF HTTPAPI 워킹그룹의 Idempotency-Key 헤더 초안이 이 헤더를 정의합니다. 값은 Structured Field 문자열이고, UUID 같은 무작위 값이 권장됩니다. 이 초안은 RFC로 확정되지 않았고 2026년 10월 기준 07판(2025-10)이 만료된 상태이지만, 결제 API를 비롯한 여러 서비스가 같은 이름과 방식으로 이미 사용하고 있습니다.
서버 처리 흐름
- 키로 저장소를 조회합니다. 키는 호출자(사용자 또는 클라이언트) 범위로 구분합니다. 다른 사용자가 같은 키를 보내도 서로 영향을 주지 않아야 합니다.
- 키가 없으면 “처리 중” 상태로 키를 먼저 기록하고, 요청 본문의 지문(fingerprint, 예: 해시)도 함께 저장합니다.
- 실제 작업을 수행하고, 결과(상태 코드 + 응답 본문)를 키 옆에 저장합니다.
- 같은 키로 요청이 다시 오면 상태에 따라 응답합니다.
| 같은 키 재요청 시 상태 | 서버 응답 (초안 기준) |
|---|---|
| 처리 완료 | 저장된 결과를 그대로 반환 (다시 실행하지 않음) |
| 아직 처리 중 | 409 Conflict — 원 요청이 끝난 뒤 재시도 |
| 같은 키, 다른 요청 본문 | 422 Unprocessable Content — 키 재사용 오류 |
| 키가 필수인데 누락 | 400 Bad Request |
구현 시 주의사항
- 키 기록은 원자적이어야 합니다. “조회 후 없으면 삽입”을 두 단계로 나누면 거의 동시에 도착한 두 요청이 모두 “없음”을 보고 둘 다 결제합니다. 키 컬럼에 유일 제약을 걸고 삽입 성공 여부로 판단합니다.
- 키는 사용자의 의도 하나당 한 번 만듭니다. 결제 버튼을 누를 때 키를 만들고, 재시도에는 그 키를 재사용합니다. 재시도마다 새 키를 만들면 아무 효과가 없습니다.
- 키에는 보관 기간을 둡니다(예: 24시간). 무기한 보관하면 저장소가 계속 커집니다. 초안은 만료 정책을 문서로 공개하도록 권고합니다.
- 하위 시스템까지 키를 전달합니다. 주문 서비스가 결제 대행사(PG)를 호출한다면, PG 호출에도 멱등성 키를 붙여야 끝까지 중복이 막힙니다.
- 재시도는 지수 백오프(exponential backoff)와 무작위 지연(jitter)을 함께 씁니다. 장애 상황에서 모든 클라이언트가 같은 간격으로 재시도하면 복구 중인 서버에 부하가 몰립니다.
5. BFF (Backend for Frontend)
해결하려는 문제
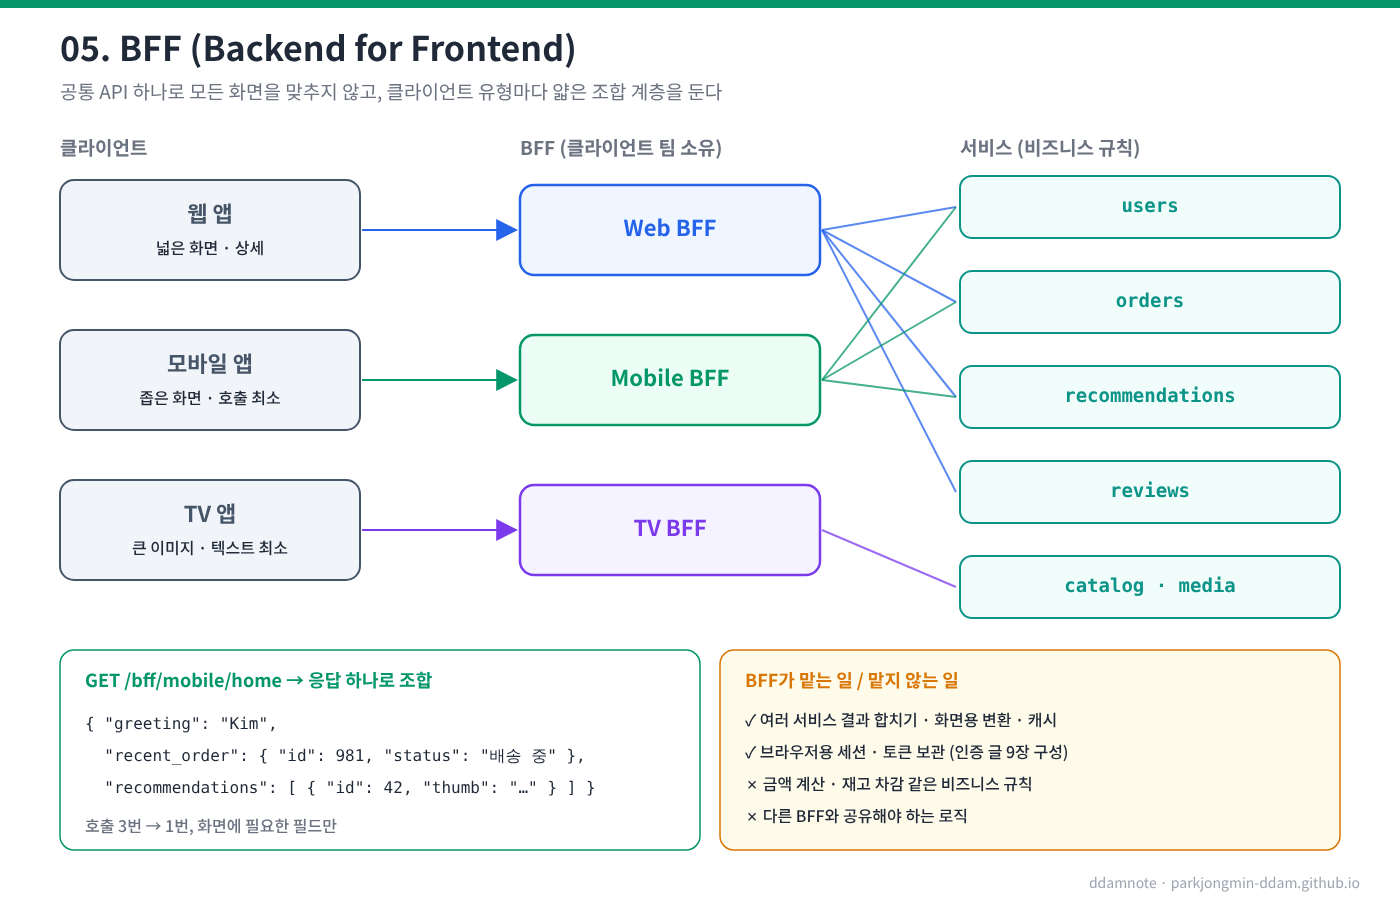
제품에 웹, 모바일, TV 앱이 생겼습니다. 세 클라이언트 모두 같은 백엔드를 쓰지만 필요한 데이터는 다릅니다.
| 클라이언트 | 화면 특성 | 필요한 데이터 |
|---|---|---|
| 웹 | 넓은 화면, 상세 정보 | 상품 상세 + 리뷰 전체 + 추천 다수 |
| 모바일 | 좁은 화면, 느린 네트워크 | 요약 정보, 호출 횟수 최소화 |
| TV | 리모컨 조작, 큰 이미지 | 대표 이미지 위주, 텍스트 최소 |
하나의 공통 API 형태로 세 클라이언트를 모두 맞추려고 하면 두 가지 중 하나가 됩니다. 모든 클라이언트가 필요 없는 데이터까지 받거나(over-fetching), 공통 API에 if (client == mobile) 같은 클라이언트별 분기가 쌓입니다. 문제는 클라이언트가 아니라 하나로 강제된 응답 형태입니다.
개념
클라이언트 유형마다 얇은 전용 API 계층을 둡니다.
모바일 앱 ──> Mobile BFF ──> users / orders / recommendations 서비스
웹 앱     ──> Web BFF    ──> users / orders / reviews / recommendations 서비스
TV 앱     ──> TV BFF     ──> catalog / media 서비스
모바일 홈 화면을 예로 들면, Mobile BFF가 사용자·주문·추천 서비스를 병렬로 호출하고, 화면에 필요한 필드만 골라 응답 하나로 합칩니다.
GET /bff/mobile/home
{
  "greeting": "Kim",
  "recent_order": { "id": 981, "status": "배송 중" },
  "recommendations": [ { "id": 42, "name": "Laptop 14", "thumb": "..." } ]
}
모바일 앱은 호출 3번 대신 1번으로 화면을 그립니다.
BFF가 맡는 일과 맡지 않는 일
| 맡는 일 | 맡지 않는 일 |
|---|---|
| 여러 서비스 호출 결과 합치기(aggregation) | 주문 금액 계산, 재고 차감 같은 비즈니스 규칙 |
| 클라이언트 화면에 맞는 응답 형태로 변환 | 데이터의 원본 저장 |
| 클라이언트별 캐시, 호출 횟수 최적화 | 다른 BFF와 공유해야 하는 로직 |
| 브라우저용 세션·토큰 처리 (아래 참고) |
- 비즈니스 규칙이 BFF에 들어가면 웹 BFF와 모바일 BFF가 같은 규칙을 각자 구현하게 되고, 결국 둘의 동작이 달라집니다. 규칙은 하위 서비스에 둡니다.
- BFF는 보통 해당 클라이언트를 만드는 팀이 함께 소유합니다. 화면이 바뀔 때 백엔드 팀을 기다리지 않고 BFF 응답을 바꿀 수 있는 것이 이 패턴의 운영상 장점입니다.
인증 관점의 BFF
인증 개념 7가지 9장의 구성이 BFF입니다. 브라우저는 세션 쿠키만 갖고, OAuth Access Token과 Refresh Token은 BFF 서버가 보관합니다. BFF는 API를 호출할 때 Authorization: Bearer 헤더에 토큰을 붙입니다. 브라우저의 JavaScript에서 토큰을 읽을 수 없으므로 XSS로 토큰이 유출될 위험이 줄어듭니다.
IETF OAuth 워킹그룹의 OAuth 2.0 for Browser-Based Applications(BCP 예정, 2026년 10월 기준 RFC 편집 대기)도 BFF를 브라우저 앱의 권장 구성 중 하나로 설명합니다.
6. API Gateway
해결하려는 문제
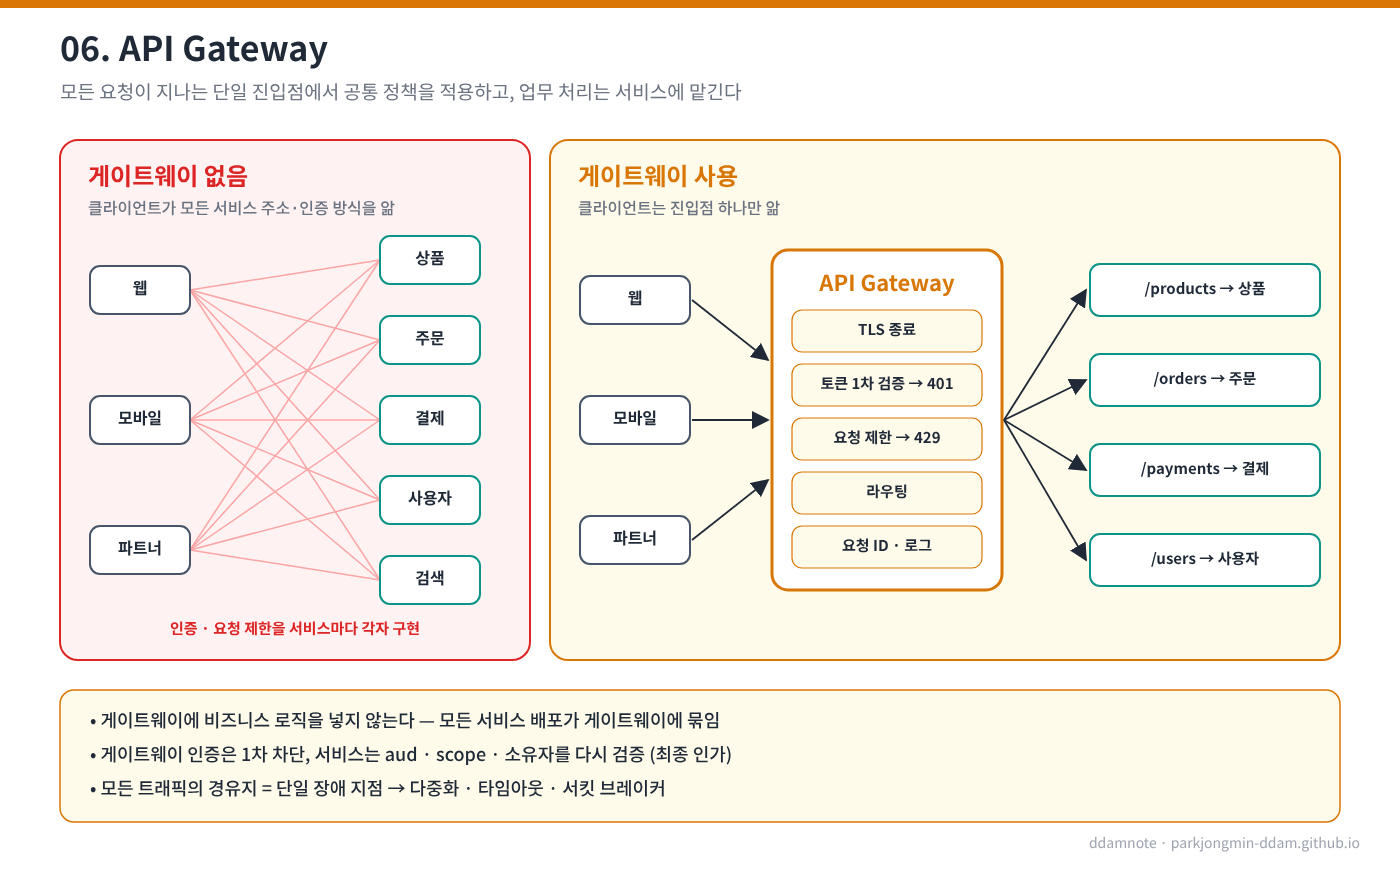
서비스가 하나에서 둘, 다섯, 열두 개로 나뉘면 클라이언트가 알아야 할 것이 늘어납니다.
- 각 서비스의 주소
- 서비스마다 다른 인증 방식
- 서비스마다 다른 요청 제한, 로깅 방식
인증과 요청 제한을 서비스마다 각자 구현하면 구현 차이로 보안 수준이 서비스마다 달라지고, 서비스 주소가 바뀌면 모든 클라이언트를 수정해야 합니다.
개념
모든 요청이 통과하는 하나의 진입점을 둡니다. 게이트웨이는 요청을 받아 공통 정책을 적용한 뒤 해당 서비스로 전달합니다.
| 기능 | 내용 |
|---|---|
| 라우팅 | /products/* → 상품 서비스, /orders/* → 주문 서비스 |
| 인증 1차 검증 | Access Token 서명·만료 확인, 실패 시 서비스까지 가지 않고 401 |
| 요청 제한 (rate limit) | 클라이언트·사용자별 호출량 제한, 초과 시 429 Too Many Requests |
| TLS 종료 | 외부 HTTPS 연결을 게이트웨이에서 종료 |
| 관측 | 요청 ID 부여, 접근 로그, 지연 시간 지표 |
| 요청 크기·형식 제한 | 과도하게 큰 본문, 허용되지 않은 메서드 차단 |
요청 제한 응답 예시입니다.
HTTP/1.1 429 Too Many Requests
Retry-After: 30
Content-Type: application/problem+json

{ "type": "https://api.example.com/problems/rate-limit", "title": "요청 한도 초과" }
429는 RFC 6585에 정의돼 있고, Retry-After로 재시도 시점을 알려 줍니다. 남은 호출량을 응답마다 알려 주는 RateLimit-Policy·RateLimit 헤더는 IETF에서 표준화가 진행 중입니다(2026년 10월 기준 초안 11판).
주의사항
- 게이트웨이를 애플리케이션으로 만들지 않습니다. 주문 금액 검증, 재고 확인 같은 비즈니스 로직이 게이트웨이에 들어가면 모든 서비스 배포가 게이트웨이 배포에 묶입니다. 게이트웨이는 모든 요청에 공통으로 적용되는 정책만 맡습니다.
- 게이트웨이에서 인증했다고 서비스의 검증을 생략하지 않습니다. 게이트웨이를 우회한 내부 호출이 있을 수 있으므로, 각 서비스는 토큰의
aud(자기 자신이 대상인지)와scope를 다시 확인하고 리소스 소유자 검사 같은 세부 인가를 수행합니다. 게이트웨이는 1차 차단, 서비스는 최종 인가입니다. - 게이트웨이는 모든 트래픽이 지나가는 지점이므로 단일 장애 지점이 됩니다. 다중화, 타임아웃, 서킷 브레이커를 함께 설계합니다.
Gateway와 BFF 비교
| 항목 | API Gateway | BFF |
|---|---|---|
| 개수 | 보통 하나 (또는 환경별 하나) | 클라이언트 유형마다 하나 |
| 관심사 | 모든 요청에 공통인 정책 | 특정 클라이언트 화면에 맞춘 응답 |
| 응답 가공 | 하지 않음 (전달) | 여러 서비스 응답을 합치고 변환 |
| 소유 | 플랫폼·인프라 팀 | 해당 클라이언트 팀 |
둘은 함께 씁니다. 일반적인 배치는 클라이언트 → Gateway → BFF → 서비스 순서입니다.
7. 비동기 API (Asynchronous APIs)
해결하려는 문제
모든 작업이 요청 하나 안에서 끝나지는 않습니다. 영상 업로드 후 인코딩, 썸네일 생성, 대량 데이터 내보내기, 보고서 PDF 생성은 수십 초에서 수십 분이 걸립니다. 이를 동기로 처리하면 다음 문제가 생깁니다.
- 클라이언트가 응답을 기다리는 동안 연결이 계속 열려 있습니다.
- 게이트웨이·로드밸런서의 타임아웃(보통 수십 초)에 걸려 작업은 진행 중인데 클라이언트는 실패 응답을 받습니다.
- 클라이언트가 실패로 판단하고 재시도하면 같은 작업이 두 번 실행됩니다.
개념
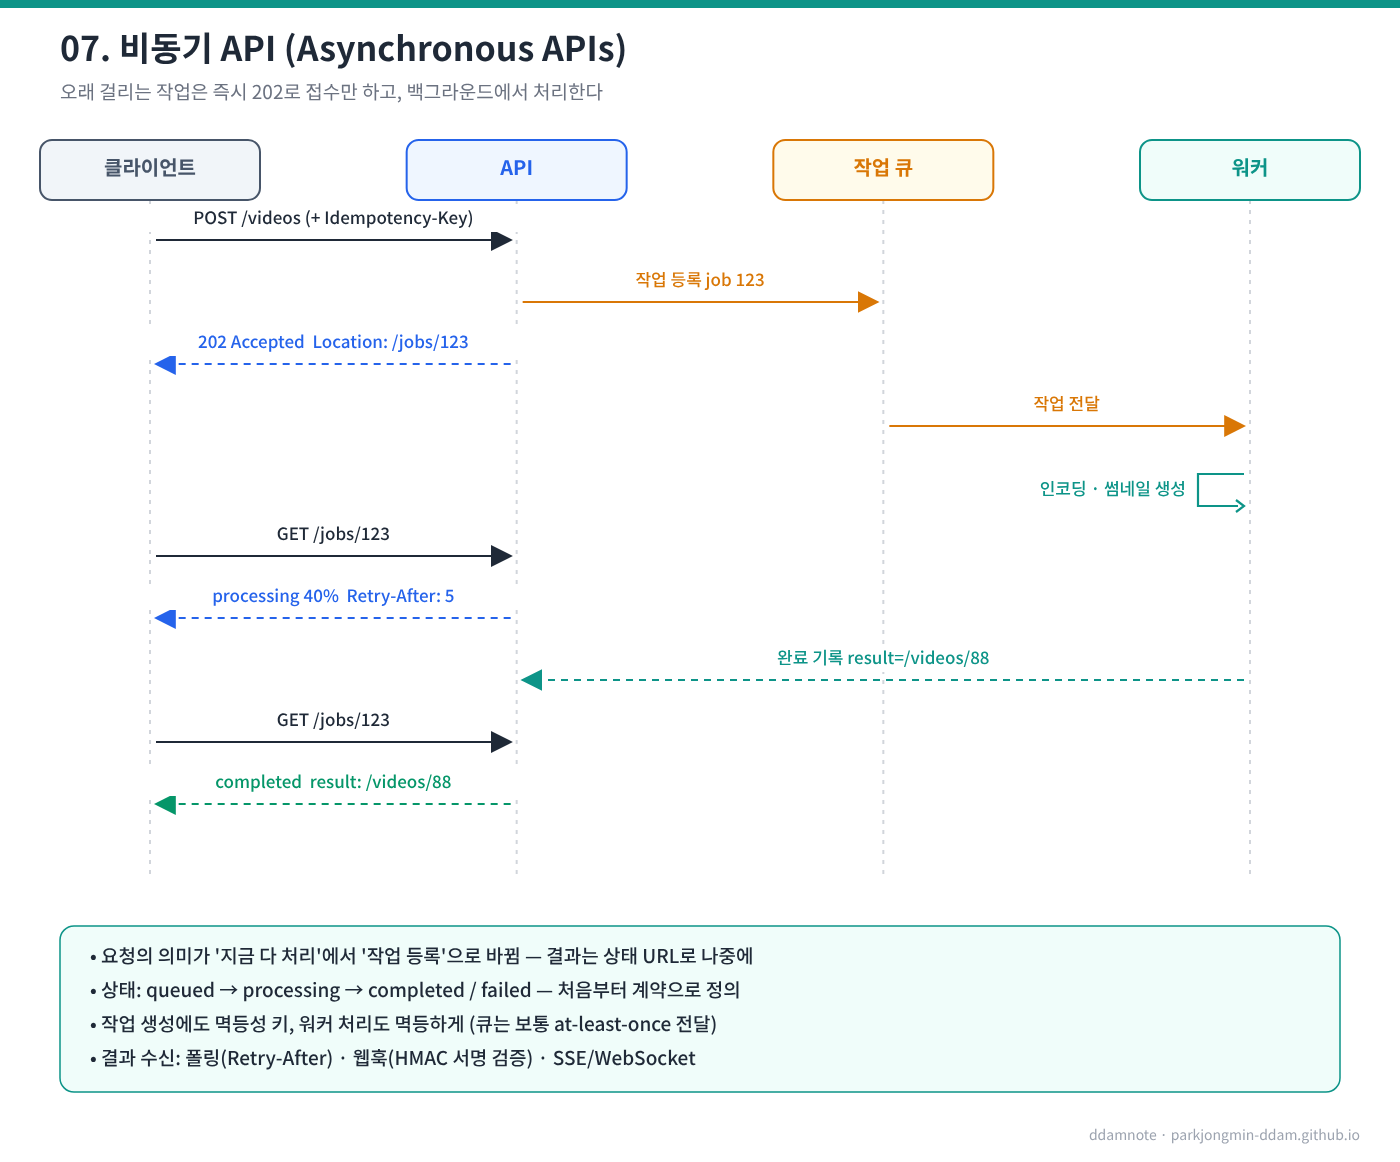
요청의 의미를 “지금 작업을 다 해 달라”에서 “작업을 등록해 달라”로 바꿉니다. 결과는 나중에 받습니다.
- 클라이언트가 작업을 요청합니다.
- 서버는 작업을 큐에 넣고 즉시
202 Accepted와 작업 상태 URL을 반환합니다. - 워커가 큐에서 작업을 꺼내 백그라운드에서 처리합니다.
- 클라이언트는 상태 URL을 조회하거나 완료 알림을 받습니다.
POST /videos HTTP/1.1
Idempotency-Key: "5b1f0c7e-..."
Content-Type: application/json

{ "upload_id": "u-551", "title": "unboxing" }
HTTP/1.1 202 Accepted
Location: /jobs/123
Content-Type: application/json

{ "job_id": "123", "status": "queued" }
RFC 9110은 202 Accepted를 “요청은 접수됐으나 처리가 완료되지 않음”으로 정의합니다. 상태 조회는 다음과 같습니다.
GET /jobs/123

200 OK
Retry-After: 5
{ "job_id": "123", "status": "processing", "progress": 40 }
GET /jobs/123

200 OK
{ "job_id": "123", "status": "completed", "result": "/videos/88" }
작업 상태
queued ──> processing ──> completed
                   └────> failed (오류 코드, 재시도 가능 여부 포함)
(선택) queued/processing ──> cancelled
상태 값은 API 계약의 일부이므로 처음부터 정의하고 문서화합니다. 나중에 상태를 추가하면 8장의 호환성 문제가 됩니다.
결과를 받는 방법
| 방식 | 동작 | 적합한 경우 |
|---|---|---|
| 폴링 | 클라이언트가 GET /jobs/{id}를 주기적으로 조회 |
구현이 단순, 클라이언트가 서버를 받을 주소가 없을 때 |
| 웹훅 | 완료 시 서버가 클라이언트에 등록된 URL로 POST |
서버 간 연동 (파트너 시스템) |
| SSE / WebSocket | 연결을 유지하고 상태 변경을 실시간 전송 | 진행률 표시가 필요한 화면 |
주의사항
- 작업 생성 요청에도 멱등성 키를 받습니다.
202응답이 유실되면 클라이언트는 작업 생성을 다시 요청하므로, 4장과 같은 이유로 중복 작업이 생깁니다. - 큐는 보통 최소 한 번(at-least-once) 전달을 보장하므로 같은 작업이 워커에서 두 번 실행될 수 있습니다. 워커의 처리도 멱등하게 만듭니다.
- 폴링 간격은
Retry-After로 서버가 알려 줍니다. 클라이언트가 임의로 짧은 간격으로 폴링하면 상태 API가 부하를 받습니다. - 웹훅은 서명(예: HMAC)을 붙여 보내고, 수신 측은 서명과 타임스탬프를 검증합니다. 서명이 없으면 누구나 “작업 완료”를 위조해 보낼 수 있습니다.
- 반복 실패한 작업은 별도 큐(dead-letter queue)로 옮겨 원인을 확인할 수 있게 합니다.
8. 버전 관리와 진화 (Versioning & Evolution)
해결하려는 문제
API는 반드시 바뀝니다. 지금 수천 개의 앱이 현재 응답 형태에 맞춰 동작하고 있는데, 6개월 뒤 응답을 바꿔야 하는 상황이 옵니다. 어떤 변경은 아무 영향이 없고, 어떤 변경은 배포 즉시 모든 클라이언트를 깨뜨립니다.
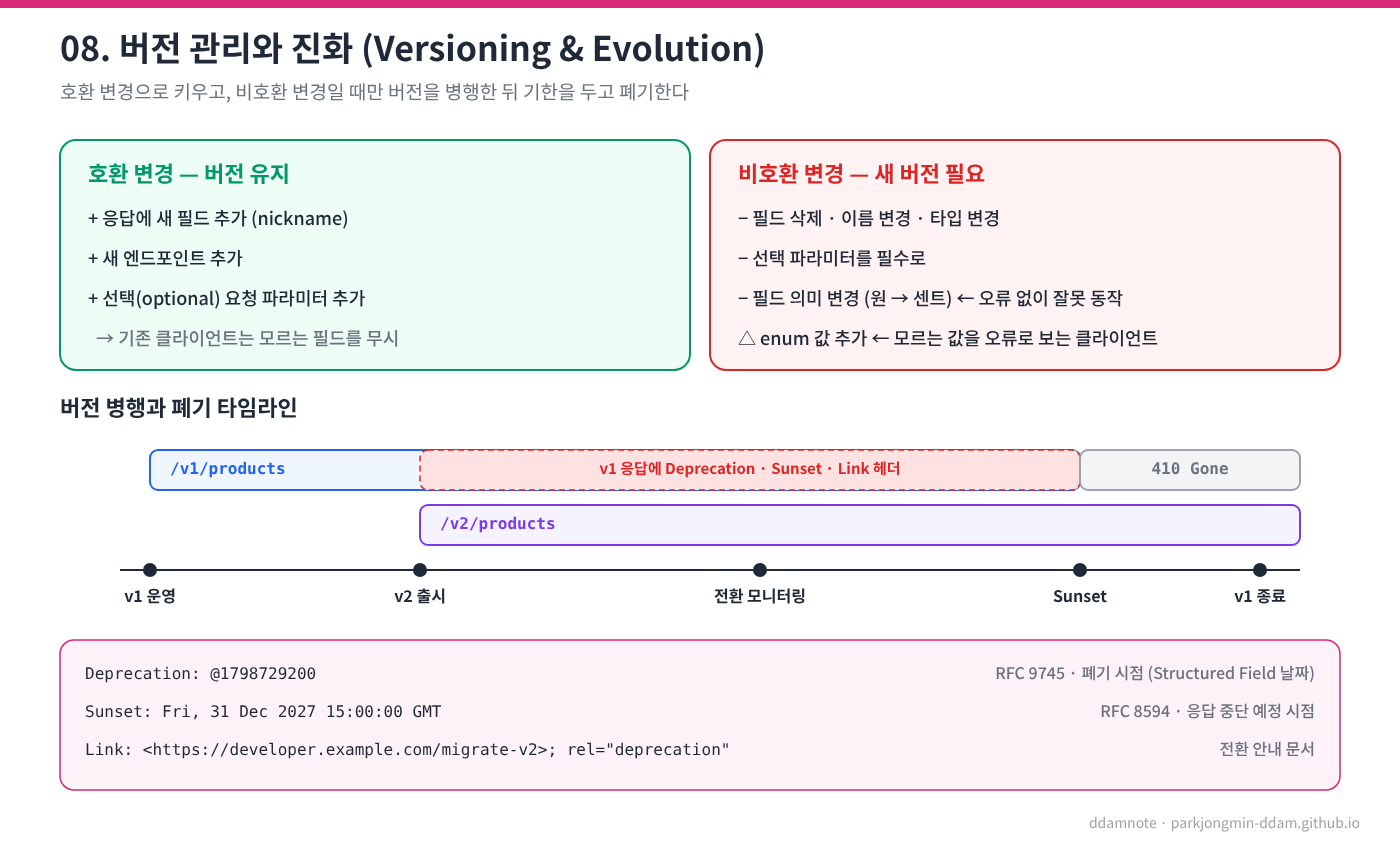
호환 변경과 비호환 변경
| 변경 | 호환 여부 | 이유 |
|---|---|---|
응답에 새 필드 추가 (nickname) |
호환 | 기존 클라이언트는 모르는 필드를 무시 |
| 새 엔드포인트 추가 | 호환 | 기존 호출에 영향 없음 |
| 선택(optional) 요청 파라미터 추가 | 호환 | 보내지 않으면 기존 동작 유지 |
| 응답 필드 삭제·이름 변경 | 비호환 | 해당 필드를 읽던 코드가 실패 |
필드 타입 변경 ("price": "899000" → 899000) |
비호환 | 파싱 실패 |
| 선택 파라미터를 필수로 변경 | 비호환 | 기존 요청이 400 |
| 기존 필드의 의미 변경 (원 → 센트 단위) | 비호환 | 형식은 같아 오류 없이 잘못된 값으로 동작 |
enum 값 추가 (status에 on_hold) |
조건부 | 모르는 값을 오류로 처리하는 클라이언트는 실패 |
- 마지막 두 줄이 가장 위험합니다. 의미 변경은 오류가 나지 않아 발견이 늦고, enum 추가는 서버 입장에서 “추가”라 안전해 보이지만 클라이언트 구현에 따라 깨집니다.
- 클라이언트는 모르는 필드와 모르는 enum 값을 무시하거나 기본 처리하도록 만듭니다(tolerant reader). 서버의 호환 변경이 실제로 호환되려면 클라이언트도 이 규칙을 지켜야 합니다.
비호환 변경이 꼭 필요할 때: 버전 병행
새 버전을 만들어 기존 버전과 함께 운영합니다. 기존 앱은 v1을 계속 쓰고, 새 앱은 v2를 씁니다.
| 버전 표시 위치 | 예시 | 특징 |
|---|---|---|
| URL 경로 | /v1/products, /v2/products |
가장 명확하고 라우팅·로그 확인이 쉬움, 가장 널리 쓰임 |
| 요청 헤더 | Api-Version: 2026-10-01 |
URL이 버전과 무관하게 유지됨, 날짜 기반 버전에 사용 |
| 미디어 타입 | Accept: application/vnd.example.v2+json |
HTTP 콘텐츠 협상 방식에 맞음, 브라우저에서 확인이 불편 |
버전은 비호환 변경이 있을 때만 올립니다. 작은 변경마다 새 버전을 만들면 서버는 여러 버전을 동시에 유지보수해야 하고, 보안 패치도 모든 버전에 적용해야 합니다. 버전 두 개는 전환 도구이고, 열 개는 운영 부담입니다.
폐기 절차
구 버전을 바로 끄지 않고, 폐기 예정을 응답 헤더로 알린 뒤 기한을 두고 종료합니다.
HTTP/1.1 200 OK
Deprecation: @1798729200
Sunset: Fri, 31 Dec 2027 15:00:00 GMT
Link: <https://developer.example.com/migrate-v2>; rel="deprecation"; type="text/html"
Deprecation(RFC 9745, 2025년 3월): 리소스가 폐기됐거나 폐기될 시점입니다. 값은 Structured Field 날짜 형식(@+ Unix 시간)입니다. 위 예시@1798729200은 2026-12-31 15:00 UTC(한국 시간 2027-01-01 00:00)입니다.Sunset(RFC 8594): 리소스가 실제로 응답을 멈출 예정 시점입니다. HTTP 날짜 형식을 쓰며,Deprecation보다 이를 수 없습니다.Link rel="deprecation": 전환 안내 문서 위치입니다.
운영 순서는 다음과 같습니다.
- v2 출시, v1에
Deprecation·Sunset·안내 링크 추가 - v1 호출 지표를 클라이언트별로 수집해 전환이 늦은 사용자에게 개별 안내
- Sunset 시점에 v1 종료, 이후 요청에는
410 Gone과 안내 링크 반환
API는 현재의 클라이언트를 깨뜨리지 않으면서 앞으로의 클라이언트를 위해 확장할 수 있도록 설계해야 합니다. 처음부터 응답을 객체로 감싸 두는 것({ "data": [...] })도 같은 이유입니다. 배열을 그대로 반환하면 나중에 next_cursor 같은 필드를 추가할 자리가 없습니다.
9. 정리: 패턴이 아니라 문제를 먼저 본다
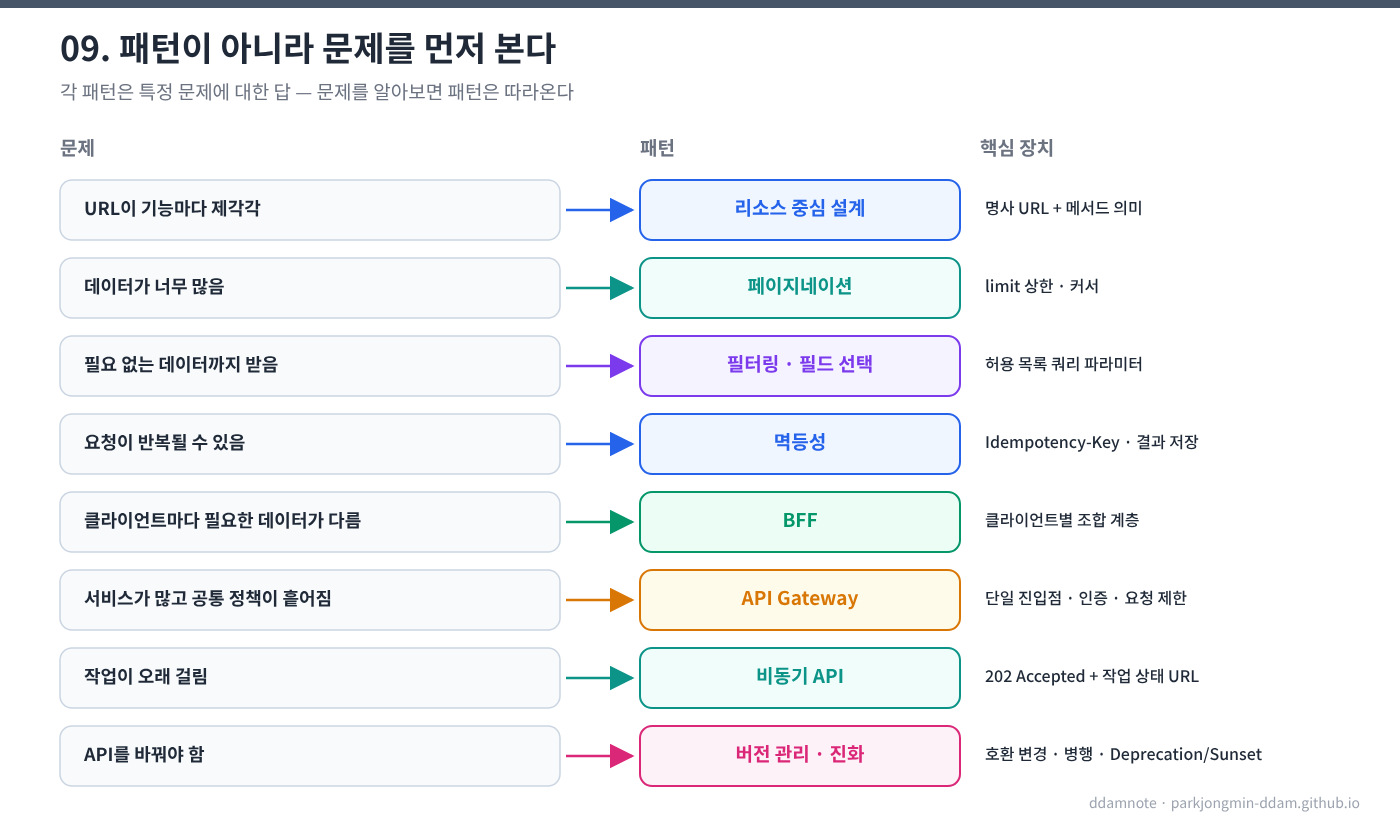
여덟 패턴을 개별 기법으로 외우기보다, 각 패턴이 해결하는 문제를 먼저 알아보는 것이 중요합니다.
| 이런 문제가 보이면 | 이 패턴을 검토 | 핵심 장치 |
|---|---|---|
| URL이 기능마다 제각각 | 리소스 중심 설계 | 명사 URL + HTTP 메서드 의미 |
| 데이터가 너무 많음 | 페이지네이션 | limit 상한, 커서 |
| 필요 없는 데이터까지 받음 | 필터링·필드 선택 | 허용 목록 기반 쿼리 파라미터 |
| 요청이 반복될 수 있음 | 멱등성 | Idempotency-Key, 결과 저장 |
| 클라이언트마다 필요한 데이터가 다름 | BFF | 클라이언트별 응답 조합 계층 |
| 서비스가 많고 공통 정책이 흩어짐 | API Gateway | 단일 진입점, 인증·요청 제한 |
| 작업이 오래 걸림 | 비동기 API | 202 Accepted + 작업 상태 URL |
| API를 바꿔야 함 | 버전 관리·진화 | 호환 변경 우선, 버전 병행, Deprecation·Sunset |
한 번의 주문에서 여덟 패턴이 함께 동작하는 방식
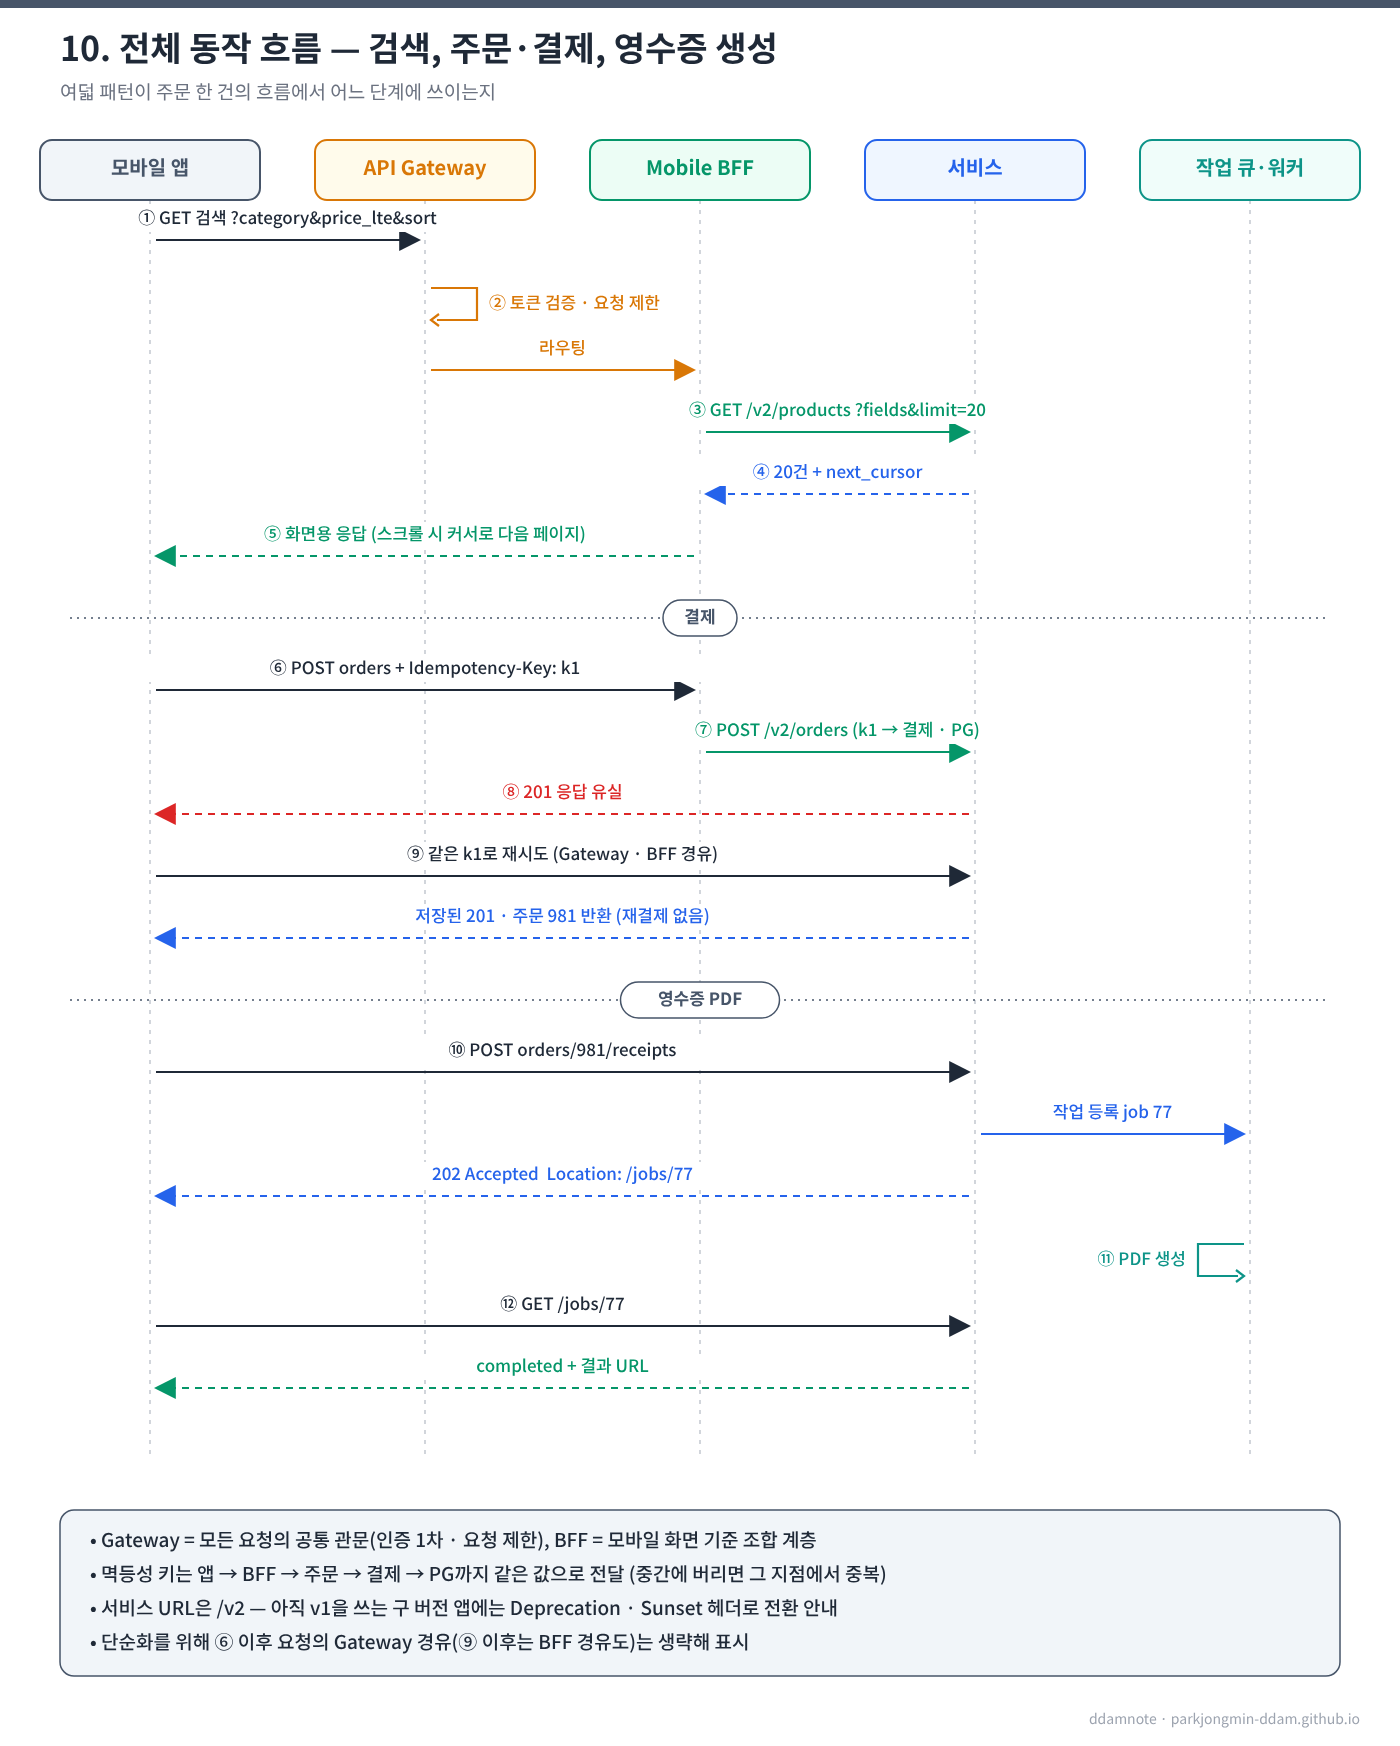
모바일 앱에서 노트북을 검색해 주문하고, 영수증 PDF를 받는 흐름입니다. 구성은 모바일 앱 → API Gateway → Mobile BFF → 서비스(상품·주문·결제) → 작업 큐·워커입니다.
| 단계 | 동작 | 적용된 패턴 |
|---|---|---|
| ① | 앱이 GET /bff/mobile/search?category=laptop&price_lte=1000000&sort=price 호출 |
필터링·정렬 |
| ② | Gateway가 토큰 서명·만료 확인, 요청 한도 확인 후 Mobile BFF로 라우팅 | API Gateway |
| ③ | BFF가 GET /v2/products?...&fields=id,name,price,thumb&limit=20 호출 |
리소스 중심 설계, 필드 선택, 버전 |
| ④ | 상품 서비스가 20건과 next_cursor 반환 |
페이지네이션 |
| ⑤ | BFF가 모바일 화면용 형태로 바꿔 응답, 스크롤 시 커서로 다음 페이지 요청 | BFF, 페이지네이션 |
| ⑥ | 결제 버튼 → 앱이 키를 만들고 POST /bff/mobile/orders + Idempotency-Key |
멱등성 |
| ⑦ | BFF가 POST /v2/orders, 주문 서비스가 결제 서비스·PG에 같은 키로 결제 요청 |
멱등성, 리소스 중심 설계 |
| ⑧ | 결제 성공 응답이 앱으로 오는 도중 유실 | |
| ⑨ | 앱이 같은 키로 재시도 → 주문 서비스가 저장된 결과(201, 주문 981)를 그대로 반환 |
멱등성 |
| ⑩ | 앱이 POST /bff/mobile/orders/981/receipts → 202 Accepted, Location: /jobs/77 |
비동기 API |
| ⑪ | 워커가 큐에서 작업을 꺼내 PDF 생성 | 비동기 API |
| ⑫ | 앱이 GET /jobs/77 → completed, 결과 URL 수신 |
비동기 API |
| ⑬ | 아직 v1을 호출하는 구 버전 앱에는 응답마다 Deprecation·Sunset 헤더가 붙음 |
버전 관리 |
- Gateway는 모든 요청의 공통 관문이고, BFF는 모바일 화면 기준의 조합 계층입니다. 둘의 역할이 겹치지 않습니다.
- 멱등성 키는 앱에서 생성돼 BFF, 주문 서비스, 결제 서비스, PG까지 같은 값으로 전달됩니다. 경로 중 한 곳이라도 키를 버리면 그 지점에서 중복이 생길 수 있습니다.
- 인증 측면에서 보면 ②의 1차 검증과 ⑦의 서비스별 인가가 인증 개념 7가지의 Access Token 검증·인가 단계에 해당합니다.
API를 설계할 때 “이 API를 어떻게 만들까”보다 “6개월 뒤 이 API에 어떤 문제가 생길까”를 먼저 묻는 것이 좋은 API 설계의 출발점입니다.
참고
- RFC 9110 — HTTP Semantics (메서드의 Safe·Idempotent 속성,
202 Accepted) - RFC 5789 — PATCH Method for HTTP
- RFC 9457 — Problem Details for HTTP APIs
- RFC 8288 — Web Linking (
Link헤더,rel="next") - RFC 6585 — Additional HTTP Status Codes (
429 Too Many Requests) - RFC 9745 — The Deprecation HTTP Response Header Field
- RFC 8594 — The Sunset HTTP Header Field
- draft-ietf-httpapi-idempotency-key-header — The Idempotency-Key HTTP Header Field
- draft-ietf-httpapi-ratelimit-headers — RateLimit Header Fields for HTTP
- draft-ietf-oauth-browser-based-apps — OAuth 2.0 for Browser-Based Applications
Comments